Docker 環境で DPDK と AF_XDP を通して仮想 NIC を扱う場合の性能
DPDK と AF_XDP は、ユーザー空間で動作するプログラムが NIC を介した I/O を行う際に、カーネルの通信に関連する実装の大部分を迂回すること(カーネルバイパス)を可能にするもので、通信性能の向上に寄与することが知られています。
これは物理 NIC だけではなく、コンテナ環境で利用される仮想 NIC においても同様の効果が期待できます。
この記事では、DPDK と AF_XDP を使ってカーネルバイパスを行うように実装されたアプリケーションが Docker 環境で仮想 NIC を扱う場合の性能について簡単な計測を通して調べます。
具体的な仮想 NIC を扱う設定方法と性能計測方法は全て記事の末尾のコマンドリストとDockerfile および compose.yaml に記載します。
計測内容は Docker の標準的な設定で実行可能かつ一台のマシンで完結するものに限定したため、ノートパソコン上の Linux をインストールした仮想マシンなどでも実行可能です。
ソフトウェアの組み合わせ
仮想 NIC
DPDK と AF_XDP では扱いやすいコンテナ環境での利用が想定された仮想 NIC が異なります。
具体的には、DPDK は virtio に関連した実装が充実している(8. Virtio_user for Container Networking — Data Plane Development Kit 25.11.0 documentation)一方で、AF_XDP は veth との親和性が高いようです。
仮想スイッチ
Linux bridge(Linux カーネルの bridge 実装)は Linux が提供する機能である veth と組み合わせやすいですが、DPDK が扱う virtio との接続には Linux カーネルの作成する tap デバイスを挟む(9. Virtio_user as Exception Path — Data Plane Development Kit 25.11.0 documentation)ことによるコストがあります。
一方で、DPDK へ対応している Open vSwitch は DPDK を利用するアプリと virtio を通した接続が容易です(DPDK vHost User Ports — Open vSwitch 3.6.90 documentation)。
これらのことから、Linux bridge を利用する場合は veth を通して AF_XDP を使いやすく、Open vSwitch を利用する場合は virtio 経由で DPDK を使うアプリと組み合わせやすいと言えると思います。
組み合わせ
上記のことから性能計測には、DPDK と AF_XDP について、それぞれ以下の組み合わせを利用します。
| フレームワーク | 仮想 NIC | 仮想スイッチ |
|---|---|---|
| DPDK | virtio | Open vSwitch |
| AF_XDP | veth | Linux bridge |
コンテナ用ネットワーク構成ソフトウェア
veth などの仮想 NIC や bridge との紐付けはコンテナ用ネットワーク構成機能を実装したソフトウェアによって行われます。
今回は Docker の標準的な設定を利用するため、各コンテナに Linux bridge と紐付けられた veth が割り当てられる構成を利用します。
Docker はそのままでは Open vSwitch の立ち上げと仮想 NIC の紐付けを行わないため、今回の計測では Open vSwitch を実行する場合には compose.yaml から専用のコンテナを起動するとともに、プログラム実行コマンド側で仮想 NIC の紐付けのための調整を行うようにします。
性能計測
ワークロード
計測に利用するソフトウェア
DPDK の場合
- 仮想スイッチ:Open vSwitch(Open vSwitch)
Open vSwitch は DPDK と組み合わせて利用できるようにコンパイルします(Open vSwitch with DPDK — Open vSwitch 3.6.90 documentation)。コンパイルの方法は Dockerfile.dpdk に記載されています。
DPDK と AF_XDP の場合の両方
- TCP/IP スタック:iip(DPDK と AF_XDP と組み合わせて利用可能な TCP/IP スタック)
- サーバー:mimicached(iip と組み合わせて利用可能な memcached 互換サーバー実装)
- クライアント:bench-iip(iip と組み合わせて利用可能なベンチマークツール)
これらをインストールした Docker イメージの作成方法は記事の末尾の Dockerfile.dpdk と Dockerfile.af_xdp に記載されています。
カーネルをバイパスしない場合
カーネルをバイパスしない一般的な構成の場合についての参考値を得るために、以下のプログラムを利用して計測を行います。
- サーバー:公式の memcached 実装(Docker Hub で配布されている公式イメージ)
- クライアント:memtier_benchmark(Docker Hub 上で RedisdLabs が配布しているイメージ)
基本的に各プログラムは一つのスレッドで実行して最大1CPU コアを利用するようにしますが、memtier_benchmark を利用する場合は十分な負荷をかけられるように4スレッドを利用することで最大4つの CPU コアを利用できるようにします。
性能計測に利用した環境
ノートパソコン上で動作する仮想マシンを利用しました。
計測結果
以下が計測の結果です。テーブル全体を見るには画面のサイズによっては横スクロールが必要かもしれません。
| 通し番号 | サーバー | クライアント | 仮想スイッチ | 利用 CPU コア数 | スループット(リクエスト毎秒) | 記事末尾の compose.yaml へのリンク |
|---|---|---|---|---|---|---|
| 1 | memcached (1 core) | memtier_benchmark (4 cores) | Linux bridge | 5 | 436073 | compose.1.yaml |
| 2 | memcached (1 core) | bench-iip on AF_XDP (1 core) | Linux bridge | 2 | 612398 | compose.2.yaml |
| 3 | mimicached on DPDK (1 core) | bench-iip on DPDK (1 core) | Open vSwitch (1 core) | 3 | 3112032 | compose.3.yaml |
| 4 | mimicached on AF_XDP (1 core) | memtier_benchmark (4 cores) | Linux bridge | 5 | 1072698 | compose.4.yaml |
| 5 | mimicached on AF_XDP (1 core) | bench-iip on AF_XDP (1 core) | Linux bridge | 2 | 1646433 | compose.5.yaml |
- 通し番号1と2の比較:サーバーがカーネルをバイパスしない公式の memcached 実装でも、クライアント側が AF_XDP を利用すると、少ない CPU コア数で高い性能が達成できる様子が見られました。
- 通し番号3:DPDK を利用している場合に5つの計測の中で最大の性能が見られました。
- 通し番号3と5の比較:注意点として、AF_XDP の最大性能よりも DPDK の場合の方が最大性能が高くなっていますが、AF_XDP の場合は CPU コアを2つしか利用しないのに対して、DPDK の場合は Open vSwitch のために CPU コアを1つ多く利用しているので、消費されている CPU リソースで換算すると、少なくともこのワークロードにおいては必ずしも AF_XDP が DPDK と比べて大幅に非効率とは言い難いと思われます。
- 通し番号1と4の比較:サーバーが AF_XDP を利用すると、クライアントがカーネルをバイパスしない memtier_bechmark の場合にも性能が2倍以上になる様子が見られました。
- 通し番号1と5の比較:サーバーとクライアント両方が AF_XDP を利用した構成では、一般的なカーネルをバイパスしない構成と比較して、3.7 倍以上の性能が見られました。
性能計測に利用したコマンドと Docker 関連ファイル
性能計測に利用したコマンドと Docker 関連のファイルを記載します。
なお、再現実験をされる場合には自己責任でお願いいたします。root 権限が必要なコマンドも含まれておりますので、ご注意ください。
この記事の作者は、この記事によって引き起こされた全ての問題についての責任を負いません。
下準備用コマンド
DPDK と Open vSwitch 利用のためのコマンド
sudo sh -c "echo 2048 > /sys/kernel/mm/hugepages/hugepages-2048kB/nr_hugepages"
sudo modprobe openvswitch
Dockerfile
Dockerfile.dpdk
以下のソフトウェアをダウンロードしてコンパイルおよびインストールします。
特に DPDK はコンパイル時にマシンごとに利用可能な CPU 命令などに合わせて最適化を行うため、コンパイル済みのプログラムをダウンロードするのではなく、ソースコードからビルドします。
FROM ubuntu:24.04

ENV TOPDIR=/
WORKDIR ${TOPDIR}

# DPDK
ENV DPDK_VER=25.11
ENV DPDK_DIR=${TOPDIR}/dpdk
ENV DPDK_SRC_DIR=${DPDK_DIR}/dpdk-${DPDK_VER}
ENV DPDK_BUILD_DIR=${DPDK_SRC_DIR}/build
ENV DPDK_INSTALL_DIR=${DPDK_DIR}/install
ENV DPDK_MESON_LIBDIR=lib/dpdk
RUN apt update; apt install -y gcc make meson python3-pyelftools libnuma-dev
ADD https://fast.dpdk.org/rel/dpdk-${DPDK_VER}.tar.xz ${DPDK_DIR}/
RUN tar xvf ${DPDK_SRC_DIR}.tar.xz -C ${DPDK_DIR}
RUN if [ "`uname -m`x" = "aarch64x" ]; then meson -Dplatform=generic --prefix=${DPDK_INSTALL_DIR} --libdir=${DPDK_MESON_LIBDIR} ${DPDK_BUILD_DIR} ${DPDK_SRC_DIR}; elif  [ "`uname -m`x" = "x86_64x" ]; then meson --prefix=${DPDK_INSTALL_DIR} --libdir=${DPDK_MESON_LIBDIR} ${DPDK_BUILD_DIR} ${DPDK_SRC_DIR}; else echo "unhandled CPU type: `uname -m`"; exit 1; fi
RUN ninja -C ${DPDK_BUILD_DIR}
RUN ninja -C ${DPDK_BUILD_DIR} install

# DPDK-compatible Open vSwitch
ENV OVS_VER=3.6.1
ENV OVS_DIR=${TOPDIR}/ovs
ENV OVS_SRC_DIR=${OVS_DIR}/ovs-${OVS_VER}
ENV OVS_INSTALL_DIR=${OVS_DIR}/install
RUN apt update; apt install -y autoconf libtool-bin pkg-config
ADD https://github.com/openvswitch/ovs/archive/refs/tags/v${OVS_VER}.tar.gz ${OVS_DIR}/
RUN tar xvf ${OVS_DIR}/v${OVS_VER}.tar.gz -C ${OVS_DIR}
RUN cd ${OVS_SRC_DIR}; ./boot.sh; export PKG_CONFIG_PATH=$PKG_CONFIG_PATH:${DPDK_INSTALL_DIR}/${DPDK_MESON_LIBDIR}/pkgconfig; export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:${DPDK_INSTALL_DIR}/${DPDK_MESON_LIBDIR}; ./configure --with-dpdk=static CFLAGS="-g -O3 -march=native" --prefix=${OVS_INSTALL_DIR} --localstatedir=${OVS_INSTALL_DIR}/var --sysconfdir=${OVS_INSTALL_DIR}/etc; make; make install

# benchmark tool using DPDK
RUN apt update; apt install -y pkg-config unzip
ADD https://github.com/yasukata/bench-iip/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv bench-iip-master bench-iip; rm master.zip
ADD https://github.com/yasukata/iip/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv iip-master ./bench-iip/iip; rm master.zip
ADD https://github.com/yasukata/iip-dpdk/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv iip-dpdk-master ./bench-iip/iip-dpdk; rm master.zip
RUN echo "" > ./bench-iip/iip-dpdk/build.mk
RUN cd bench-iip; CFLAGS=`PKG_CONFIG_PATH=${DPDK_INSTALL_DIR}/${DPDK_MESON_LIBDIR}/pkgconfig pkg-config --cflags libdpdk` LDFLAGS=`PKG_CONFIG_PATH=${DPDK_INSTALL_DIR}/${DPDK_MESON_LIBDIR}/pkgconfig pkg-config --libs libdpdk` IOSUB_DIR=./iip-dpdk make

# memcached-compatible server using DPDK
ADD https://github.com/yasukata/mimicached/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv mimicached-master mimicached; rm master.zip
ADD https://github.com/yasukata/memcached-protocol-parser/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv memcached-protocol-parser-master mimicached/memcached-protocol-parser; rm master.zip
RUN ln -s /bench-iip/iip /mimicached; cd mimicached; CFLAGS=`PKG_CONFIG_PATH=${DPDK_INSTALL_DIR}/${DPDK_MESON_LIBDIR}/pkgconfig pkg-config --cflags libdpdk` LDFLAGS=`PKG_CONFIG_PATH=${DPDK_INSTALL_DIR}/${DPDK_MESON_LIBDIR}/pkgconfig pkg-config --libs libdpdk` IOSUB_DIR=../bench-iip/iip-dpdk make
以下のコマンドでビルドします。
docker build -f Dockerfile.dpdk -t experiment-dpdk:1.0 .
Dockerfile.af_xdp
以下のソフトウェアをダウンロードしてコンパイルおよびインストールします。
FROM ubuntu:24.04

WORKDIR /

# benchmark tool using AF_XDP
RUN apt update; apt install -y unzip gcc make libnuma-dev libxdp-dev
ADD https://github.com/yasukata/bench-iip/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv bench-iip-master bench-iip; rm master.zip
ADD https://github.com/yasukata/iip/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv iip-master ./bench-iip/iip; rm master.zip
ADD https://github.com/yasukata/iip-af_xdp/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv iip-af_xdp-master ./bench-iip/iip-af_xdp; rm master.zip
RUN mv /bench-iip/iip-af_xdp/main.c /bench-iip/iip-af_xdp/_main.c; echo "#define helper_ip4_get_connection_affinity __helper_ip4_get_connection_affinity" > /bench-iip/iip-af_xdp/main.c; echo "#include \"_main.c\"" >> /bench-iip/iip-af_xdp/main.c; echo "#undef helper_ip4_get_connection_affinity" >> /bench-iip/iip-af_xdp/main.c; echo "static uint16_t helper_ip4_get_connection_affinity(uint16_t protocol, uint32_t local_ip4_be, uint16_t local_port_be, uint32_t peer_ip4_be, uint16_t peer_port_be, void *opaque) { return 0; (void) protocol; (void) local_ip4_be; (void) local_port_be; (void) peer_ip4_be; (void) peer_port_be; (void) opaque; (void) __helper_ip4_get_connection_affinity; }" >> /bench-iip/iip-af_xdp/main.c
RUN cd bench-iip; IOSUB_DIR=./iip-af_xdp make

# memcached-compatible server using AF_XDP
ADD https://github.com/yasukata/mimicached/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv mimicached-master mimicached; rm master.zip
ADD https://github.com/yasukata/memcached-protocol-parser/archive/refs/heads/master.zip ./
RUN unzip ./master.zip; mv memcached-protocol-parser-master mimicached/memcached-protocol-parser; rm master.zip
RUN ln -s /bench-iip/iip /mimicached; ln -s /bench-iip/iip-af_xdp /mimicached; cd mimicached; IOSUB_DIR=./iip-af_xdp make
以下のコマンドでビルドします。
docker build -f Dockerfile.af_xdp -t experiment-af_xdp:1.0 .
compose.yaml
compose.1.yaml
services:
  memcached:
    image: memcached:1.6.40-alpine3.23
    command:
      - --memory-limit=1024
      - --threads=1
  memtier_benchmark:
    depends_on:
      - memcached
    image: redislabs/memtier_benchmark:2.2.0
    command: -h memcached -p 11211 -P memcache_text -t 4 -c 64 --key-maximum 1 --ratio=0:1 --test-time=10
compose.2.yaml
services:
  memcached:
    image: memcached:1.6.40-alpine3.23
    command:
      - --memory-limit=1024
      - --threads=1
  client:
    depends_on:
      - memcached
    image: experiment-af_xdp:1.0
    cap_add:
      - SYS_NICE
      - SYS_ADMIN
      - NET_ADMIN
      - IPC_LOCK
      - BPF
    command: sh -c "/bench-iip/a.out -l 1 -i eth0 -- -s `getent hosts memcached | awk '{ print $1 }'` -p 11211 -m \"```echo -e 'get a\\r\\n\0'```\" -c 64"
compose.3.yaml
services:
  ovs:
    image: experiment-dpdk:1.0
    cap_add:
      - SYS_NICE
      - NET_ADMIN
    devices:
      - /dev/net/tun:/dev/net/tun
    volumes:
      - /dev/hugepages:/dev/hugepages
      - ./tmp-sock:/ovs/install/var/run/openvswitch
    command: sh -c "rm /ovs/install/var/run/openvswitch/br0.*; rm /ovs/install/var/run/openvswitch/db.sock; rm /ovs/install/var/run/openvswitch/ovs-vswitchd.*; rm /ovs/install/var/run/openvswitch/ovsdb-server.*; rm /ovs/install/var/run/openvswitch/vhost*; /ovs/install/share/openvswitch/scripts/ovs-ctl start; /ovs/install/bin/ovs-vsctl --no-wait set Open_vSwitch . other_config:dpdk-init=true; /ovs/install/share/openvswitch/scripts/ovs-ctl stop; /ovs/install/share/openvswitch/scripts/ovs-ctl start; /ovs/install/bin/ovs-vsctl del-br br0; ovs/install/bin/ovs-vsctl add-br br0 -- set bridge br0 datapath_type=netdev; /ovs/install/bin/ovs-vsctl add-port br0 dport0 -- set Interface dport0 type=dpdkvhostuserclient options:vhost-server-path=/ovs/install/var/run/openvswitch/vhost0; /ovs/install/bin/ovs-vsctl add-port br0 dport1 -- set Interface dport1 type=dpdkvhostuserclient options:vhost-server-path=/ovs/install/var/run/openvswitch/vhost1; /ovs/install/bin/ovs-vsctl show; tail -f /dev/null"
  mimicached:
    depends_on:
      - ovs
    image: experiment-dpdk:1.0
    cap_add:
      - SYS_NICE
      - IPC_LOCK
    volumes:
      - /dev/hugepages:/dev/hugepages
      - ./tmp-sock:/var/run/dpdk-app
    command: sh -c "sleep 2; LD_LIBRARY_PATH=/dpdk/install/lib/dpdk /mimicached/a.out -l 1 --proc-type=primary --file-prefix=pmd1 --vdev=net_virtio_user0,path=/var/run/dpdk-app/vhost0,server=1 --no-pci --single-file-segments -- -a 0,10.100.0.20 -e 0 -- -p 11211 -m 10000 -z 100000"
  client:
    depends_on:
      - ovs
    image: experiment-dpdk:1.0
    cap_add:
      - SYS_NICE
      - IPC_LOCK
    volumes:
      - /dev/hugepages:/dev/hugepages
      - ./tmp-sock:/var/run/dpdk-app
    command: sh -c "sleep 2; LD_LIBRARY_PATH=/dpdk/install/lib/dpdk /bench-iip/a.out -l 2 --proc-type=primary --file-prefix=pmd2 --vdev=net_virtio_user1,path=/var/run/dpdk-app/vhost1,server=1 --no-pci --single-file-segments -- -a 0,10.100.0.10 -e 0 -- -s 10.100.0.20 -p 11211 -m \"```echo -e 'get a\\r\\n\0'```\" -c 64"
    tty: true
compose.4.yaml
services:
  mimicached:
    image: experiment-af_xdp:1.0
    cap_add:
      - SYS_NICE
      - SYS_ADMIN
      - NET_ADMIN
      - IPC_LOCK
      - BPF
    command: sh -c "/mimicached/a.out -l 0 -i eth0 -- -p 11211 -m 1024 -z 100000"
  memtier_benchmark:
    depends_on:
      - mimicached
    image: redislabs/memtier_benchmark:2.2.0
    command: -h mimicached -p 11211 -P memcache_text -t 4 -c 64 --key-maximum 1 --ratio=0:1 --test-time=10
compose.5.yaml
services:
  mimicached:
    image: experiment-af_xdp:1.0
    cap_add:
      - SYS_NICE
      - SYS_ADMIN
      - NET_ADMIN
      - IPC_LOCK
      - BPF
    command: sh -c "/mimicached/a.out -l 0 -i eth0 -- -p 11211 -m 1024 -z 100000"
  client:
    depends_on:
      - mimicached
    image: experiment-af_xdp:1.0
    cap_add:
      - SYS_NICE
      - SYS_ADMIN
      - NET_ADMIN
      - IPC_LOCK
      - BPF
    command: sh -c "/bench-iip/a.out -l 1 -i eth0 -- -s `getent hosts mimicached | awk '{ print $1 }'` -p 11211 -m \"```echo -e 'get a\\r\\n\0'```\" -c 64"
実行は以下のコマンドで行います。実行時には以下の FILE の箇所を compose.1.yaml のようにファイル名と置き換えます。
docker compose -f FILE up
まとめ
Docker 環境で、標準的なコンテナ用ネットワーク構成を大幅に変更しないまま、DPDK と AF_XDP を利用したアプリケーションが仮想 NIC を扱う場合の性能について簡単な計測を行いました。
memcached 互換サーバーの自作
memcached プロトコルに則ったリクエストを通して基本的なキー・バリューペアの保存と取り出しができるサーバーを自作しています。
ソースコードはこちらで公開しておりますので、よろしければお試しください。
通信部分には、以前から自作している TCP/IP スタックを利用できるようにしています。また、自作 TCP/IP スタックではなく、Linux 等のカーネルの TCP/IP スタックを利用するバージョンもあります。
実装の内容
memcached サーバーがクライアントからのリクエストに応答する際のおおよその挙動は以下の通りです。
- リクエストメッセージの受信:クライアントから memcached プロトコルに則ったフォーマットで送信されてきたリクエスト内容を含むメッセージを受信する。
- メッセージのパース:クライアントから送られてきたメッセージをパースして、リクエスト内容を判別する。
- キー・バリュー操作:判別されたリクエスト内容に応じてキー・バリューペアの保存や検索を行う。
- レスポンスメッセージの送信:キー・バリュー操作の結果を memcached プロトコルに則ったフォーマットにして、クライアントへ送信する。
これらは主に「メッセージの送受信」「memcached プロトコルに則ったメッセージのパースと応答の生成」「キー・バリュー操作」の三つの要素に分けられます。
自作 memcached 互換サーバーを作成するためには、自作 TCP/IP スタックが担当する「メッセージの送受信」以外の「memcached プロトコルに則ったメッセージのパースと応答の生成」「キー・バリュー操作」の機能が不足しているため、これらを実装します。
実装で配慮した点
実装の再利用性
以前から手軽に memcached プロトコルに則った挙動ができるサーバーを簡単に実装できたらいいなと思うことが何度かあったため、特に memcached プロトコルのパーサーと応答生成部分がなるべく再利用しやすいように配慮しました。
主な配慮の一つは、CPU、OS、固有のライブラリやコンパイラ機能等に極力依存しないようにすることです。また、なるべく多くのコンパイラでコンパイルが可能なように C89 と C++98 という C 言語の標準に準拠させます。
もう一点は、再利用性の高い memcached プロトコルパーサーとキー・バリュー操作の間のインターフェースを定義することですが、こちらはインターフェースが複雑にならず、かつ様々なキー・バリュー操作の実装に対応できるようにすることが中々難しく、特に、当初はキー・バリュー操作機能が memcached 固有のキー・バリューペアのフラグや有効期限についての情報を持つ必要がないようにしたかったのですが、ロックを取らない楽観的な排他制御を適用したい場合に、どのタイミングでバージョンを判断する変数を読み取るか、どのタイミングで読み取ったバージョンと最新のバージョンの値を比較するか、それらが異なった場合にどこからリトライするのか、というような点について、キーバリュー操作の実装に依存しない一般的なプロトコルパーサー側からのキー・バリュー操作に関連した機能の呼び出しタイミングとループの操作を見出すことが難しく、結局は、キー・バリュー操作側にも memcached 固有の情報を持たせることにしました。
この妥協のおかげで、ある程度色々なキー・バリュー操作機能の実装と組み合わせることができるようになっていると思います。
一方で、この妥協の欠点は、仮に新しくハッシュテーブルを開発した人がこのプロトコルパーサー実装を使って memcached 互換サーバーを実装しようとすると、その人は統合作業の中で memcached 固有の情報を操作する実装をする必要があるということです。特に、ms (meta set) や mg (meta get) のようなメタプロトコルのコマンドは挙動が若干複雑なので、統合作業に際してこれらの挙動を認識する必要があるというのは面倒な点です。
応答の挙動をなるべく公式の memcached 実装に近づける
プロトコルパーサーは memcached のテキストプロトコル、メタプロトコル、バイナリプロトコルに対応する、また、なるべく公式の実装と同じエラーメッセージが返されるようにするようにします。
このために、エラーを含むリクエストを公式の memcached と自作 memcached 互換サーバーの両方に送って、同じ結果が返されるかを確認するテストプログラムを用意しました。
利用する CPU コアの増加とともに性能が向上するようにする
利用する CPU コアの増加にあわせて性能を向上できるように、キー・バリューペアを保持するハッシュテーブルへのアクセスの排他制御方法を工夫します。
具体的には、あるスレッドがロックを獲得した後で、そのロックが解放される前に、別のスレッドが同じロックを獲得しようとすると、そのスレッドはロックが解放されるまで待機する必要があり、この待機時間の蓄積が単位時間あたりに処理可能なリクエスト数の低下につながります。
このため、ハッシュテーブル実装において、キー・バリューペアの追加また更新は CPU の compare and swap 機能を元に実装し、読み書き共にロックの獲得が不要になるようにしました。
また、キャッシュの追い出しポリシーも CPU 間の同期が少なくて済むように配慮します。Least Recently Used (LRU) のようなポリシーの実装は CPU コア間での同期が多くなりやすいため採用を見送りました。少し調べてみて、ランダムな追い出しはキャッシュヒット率の観点からは最適ではないものの、必ずしも悪いアルゴリズムではないようだったので、こちらを採用しました。
2025年11月8日 追記
ハッシュテーブル実装について、上では「読み書き共にロックの獲得が不要になるようにしました」と記載しましたが、ロックを使って排他制御を行う方が高い性能が見られたため、ロックを必要としない実装から、ロックを使う実装に変更しました。
簡単な性能計測
自作した memcached 互換サーバーの性能を簡単に計測してみます。
実験環境
二台の同じ以下の設定のマシンを利用します。
memcached 用ワークロード
自作 TCP/IP スタックを利用する memcached サーバー向けクライアントを使用して以下のワークロードを実行します。
- キー・バリューペア総数:1000 件
- キーのサイズ:8バイト
- バリューのサイズ:8バイト
- リクエストの分布:一様にランダム
- set と get の割合:get 100%(1000 件のキー・バリューペアは計測開始時にサーバー側に全てロードされている)
- プロトコル:テキストプロトコル
キー・バリュー操作の負荷が特に小さい場合の性能を見るためにキー・バリューペアの総数を 1000 件という少ない件数に設定しています。
サーバーは自作 TCP/IP スタックを利用する自作 memcached 互換サーバーと、Linux カーネルの TCP/IP スタックを利用する公式の memcached バージョン 1.6.39 の2通りです。
TCP メッセージ往復ワークロード
また、memcached の応答についての処理のうち「memcached プロトコルに則ったメッセージのパースと応答の生成」「キー・バリュー操作」を含まない「メッセージの送受信」だけの場合の性能の目安を得るために、サーバーとクライアント間で 16 バイトのメッセージを往復させた場合のスループットも計測します。
この場合のベンチマークプログラムはサーバーとクライアント共にこちらの実装を利用します。また、Linux カーネルの TCP/IP スタックを利用する場合のサーバーはこのリンクの please click here to show the code of the program タブを開いた先のものを利用します。クライアントは常に自作 TCP/IP スタックを利用します。
計測結果
以下のテーブルに1秒間に往復できたメッセージの数を記載しています。注意点として、Linux カーネルの TCP/IP スタックと自作 TCP/IP スタックの性能、公式の memcached サーバーと自作 memcached 互換サーバーの性能を比較することは公平ではないため、目安としてご覧ください。
| CPU コア数 | TCP メッセージ往復(Linux カーネルの TCP/IP スタック) | 公式 memcached(Linux カーネルの TCP/IP スタック) | TCP メッセージ往復(自作 TCP/IP スタック) | 自作 memcached (自作 TCP/IP スタック) |
| 1 | 251,998 | 221,158 | 2,942,829 | 1,796,002 |
| 2 | 518,701 | 416,550 | 5,443,978 | 3,108,503 |
| 4 | 953,781 | 775,122 | 10,548,274 | 6,115,211 |
| 8 | 1,736,528 | 1,532,406 | 22,491,567 | 12,247,723 |
| 16 | 3,320,573 | 2,856,584 | 42,728,778 | 23,766,128 |
| 32 | 5,009,303 | 4,515,630 | 69,237,228 | 31,957,330 |
自作の memcached 互換サーバーの性能は自作 TCP/IP スタック実装の性能を反映したものになっているように見えます。また、ある程度 CPU コアの増加にあわせて性能が上がる様子を見ることができました。
他のワークロード
今度はキー・バリューペア数を増やして、リクエストの分布も zipf 分布の近似に変更、また、リクエスト全体のうち 10% は set で上書きをするようにしてみました。
- キー・バリューペア総数:1,000,000 件
- キーのサイズ:8バイト
- バリューのサイズ:8バイト
- リクエストの分布:zipf 分布の近似
- set と get の割合:set 10% get 90%(1000000 件のキー・バリューペアは計測開始時にサーバー側に全てロードされている)
- プロトコル:テキストプロトコル
1秒間にサーバーとクライアントの間で往復できたメッセージ数は以下の通りです。
| CPU コア数 | 公式 memcached(Linux カーネルの TCP/IP スタック) | 自作 memcached (自作 TCP/IP スタック) |
| 1 | 202,487 | 1,201,418 |
| 2 | 392,694 | 2,041,757 |
| 4 | 718,106 | 3,915,976 |
| 8 | 1,378,252 | 7,650,862 |
| 16 | 2,344,839 | 14,625,274 |
| 32 | 3,192,569 | 23,194,445 |
先ほどの計測結果と比べて、数値の低下が見られます。これは、キー・バリューペアの総数が増えてアクセスが発生し得るメモリ領域の範囲が拡大したことによる CPU キャッシュ効率の低下と、一部 set を行うことによる負荷の増加が要因と予想しています。
2025年11月8日 追記
ベンチマーククライアントのリクエスト分布の実装の誤りの修正と性能の改善を行い、サーバー側のハッシュテーブル実装を改善した後の、同様の計測の結果を以下に記載します。
| CPU コア数 | 公式 memcached(Linux カーネルの TCP/IP スタック) | 自作 memcached (自作 TCP/IP スタック) |
| 1 | 242,517 | 1,670,782 |
| 2 | 410,582 | 2,765,230 |
| 4 | 760,699 | 5,443,889 |
| 8 | 1,408,281 | 10,854,796 |
| 16 | 2,526,256 | 20,917,341 |
| 32 | 2,175,208 | 36,090,327 |
TCP/IP スタックを自作する
最近、TCP/IP スタックを自作しており、少し動くようになってきたので、それについて記事にしてみようと思いました。
主に、ポータブル(特定の CPU、NIC、OS、ライブラリ、コンパイラ機能に依存しない)かつマルチコア環境で利用できる実装があればいいなと思ったことが、モチベーションになっています。
まだ実装の途中ではありますが、ソースコードは GitHub に置いてありますので、よろしければお試しください。
GitHub - yasukata/iip: iip: an integratable TCP/IP stackgithub.com
モチベーション
TCP/IP スタック実装はインターネット上でいくつか見つけることができるのですが、それらの多くが可搬性についてあまり意識されておらず、込み入ったことをしようと思うと取り回しが良くない、というような印象を持っていました。
具体的には、既存の多くの TCP/IP スタック実装が、
- 特定の OS、ライブラリやネットワーク I/O 機能の実装(例えば tap デバイスや DPDK 等)に依存し、
- 更に、内部でそれらを利用するためのサブシステムが独自に実装されており、かつ、それらが外部から隠蔽されている
- また、TCP/IP スタック実装に、TCP/IP スタックの処理を実行するスレッドが含まれている
結果として、
ということがあると思いました。
1. 他のシステムとの統合・コンパイルそのものが難しい場合がある
例えば、ある TCP/IP スタック実装を、pthread (カーネルによって管理されるスレッド)をユーザー空間スレッドに置き換えるようなアイデア・実装 (e.g., Shenango (NSDI'19), Caladan (OSDI'20)) と組み合わせたいと考えた場合に、その TCP/IP スタック実装が pthread と pthread を想定したロックに依存していた場合、統合・コンパイル自体が難しくなります。
また、新しく設計・実装された OS 等の、既存の標準ライブラリとの互換性が十分でないシステムの上では、標準ライブラリに依存する TCP/IP スタックの実装を動かすことは難しいです。
更に、TCP/IP スタック実装が依存するライブラリやビルド環境の中に一つでもうまく機能しないものがあると、ビルド自体が成功しなかったり、コンパイルできても利用者側から解消が難しいバグ等で実装全体が利用できなくなってしまうことがあるため、依存関係はなるべく新規に作らない方が利用者側はありがたい場合が多いと思いました。
2. 機能の隠蔽により、最適化がしにくくなる場合がある
例として、ディスクからメモリへ読み込んだデータをそのままヘッダだけ付与して NIC から転送する sendfile システムコールと同様の挙動を実装しようとすると、既存の TCP/IP スタック実装の多くが、NIC に紐づいているパケットバッファを TCP/IP スタック実装の内部で独自に確保・使用し、更に、それは TCP/IP スタック実装外部へは隠蔽されており、ディスク上のデータの読み込み先として指定することが難しいため、sendfile のようなディスクと NIC の間のデータの移動でコピーを削減する機能を実装しにくいというようなことがあります。
3. TCP/IP のプロトコル処理を行うスレッドの実行形式が限定されてしまう
多くの TCP/IP スタック実装は自前でプロトコル処理を実行するスレッドとその起動部分も含めて実装しており、結果として、CPU 効率の良くない実行形式を採用せざるを得なくなるということがあります。
TCP/IP スタック実装が自前でプロトコル処理を実行するスレッドを実装することの弊害
具体的には、TCP/IP スタック実装が自前でプロトコル処理を実行するスレッドを実装すると、以下のようなキューを通してアプリとやり取り・連携を行う場合が多いと思います。以下の疑似コードの中では net_thread_fn が TCP/IP スタック実装に含まれ、初期化時に自動的に起動されるものとします。
shared_rx_payload_queue;
shared_tx_payload_queue;

net_thread_fn() {
  while (1) {
    // NIC から受信パケットを取り出す
    rx_pkt = nic_rx();
    // 受信パケットをプロトコルスタックに渡しペイロードを取得
    rx_payload = tcpip_rx(rx_pkt);
    // 受信したペイロードをアプリの受信キューに入れる
    enqueue(shared_rx_payload_queue, rx_payload);
    // アプリの送信キューからペイロードを取り出す
    tx_payload = dequeue(shared_tx_payload_queue);
    // 送信用ペイロードにプロトコル処理を施してパケットにする
    tx_pkt = tcpip_tx(tx_payload);
    // パケットを NIC から送信する
    nic_tx(tx_pkt);
  }
}
この場合、TCP/IP スタック実装利用者(アプリ開発者)は以下のように独自でアプリ固有の処理を実行するスレッドを実装することになります;アプリは shared_rx/tx_payload_queue を通して、TCP/IP スタック実装とデータのやり取りを行います。
shared_rx_payload_queue;
shared_tx_payload_queue;

app_thread_fn() {
  while (1) {
    // アプリの受信キューからペイロードを取り出す
    rx_payload = dequeue(shared_rx_payload_queue);
    // アプリ固有の処理で応答データを生成
    tx_payload = handle_request(rx_payload);
    // アプリの送信キューへペイロードを入れる
    enqueue(shared_tx_payload_queue, tx_payload);
  }
}
上記の形式の問題は、TCP/IP スタックのプロトコル実装を行うスレッドとアプリを実行するスレッドが別になってしまい、CPU 利用効率を最大化するのが難しくなるということがあります。
具体的には、例えば、以下を設定1として、
- CPUコア0 が TCP/IP スタックの処理 net_thread_fn のスレッドを実行し、
- CPUコア1 がアプリ固有の処理 app_thread_fn のスレッドを実行する
とすると、
仮に、アプリのワークロードがプロトコル処理よりも重い場合、アプリを実行する CPU1 は使用率が 100% になる一方で、プロトコル処理を行う CPU0 の使用率は例えば 10% 程度に留まるようなことが考えられます。この場合、CPU0 の残りの 90% の CPU 時間はこのアプリのために利用することはできないため、本来2つの CPU コアで 200% 分の CPU 時間を利用できる環境でも 110% しか CPU 時間を利用できなくなってしまいます。
言い換えると、この設定1では、TCP/IP スタックの処理に必要な CPU 時間とアプリの処理に必要な CPU 時間が一致した時以外は、CPU が意味のある仕事をしない空き時間ができしまいます。
別の可能性として、以下を設定2とすると、
- CPUコア0 が TCP/IP スタックの処理 net_thread_fn のスレッドとアプリ固有の処理 app_thread_fn のスレッド両方を実行する
- CPUコア1 も TCP/IP スタックの処理 net_thread_fn のスレッドとアプリ固有の処理 app_thread_fn のスレッド両方を実行する
というように、二つのスレッドを一つの CPU コアで動かし、それを複数の CPU コアで行うという方法も考えられます。
この設定2の場合であれば、それぞれのスレッドが仕事がない時には CPU を手放すように実装されていると、TCP/IP スタックの処理が使わなかった CPU 時間はアプリが使うことができ、逆も可能であるため、先述の設定のような 110% しか合計で CPU 時間を利用できない、というようなことはなくなり、CPU 時間を最大限 200% まで使えるようになると思われます。
ただ、こちらの設定2は、同一 CPU コアの上で動作する二つのスレッドの切り替えが頻繁に行われる必要があり、プロセス・スレッドスケジューリングの負荷が追加されることによる性能の劣化の懸念があります。更に、TCP/IP スタック実装が DPDK のような仕事がなくても CPU を手放さないシステムを採用していると、スレッド間の切り替え頻度が低くなり、性能が大幅に劣化することが予想されます。
TCP/IP スタック実装が自前でプロトコル処理を実行するスレッドを実装しないことの利点
一方で、TCP/IP スタック実装に、TCP/IP スタックの処理を実行するスレッドが含まれていない場合には、以下のようにプロトコル処理を含むネットワーク関連の処理と、アプリ固有のリクエストについて応答を生成する処理を同じ while ループに含めることができ、上記の二つの設定の問題を全て回避することができます。
thread_fn() {
  while (1) {
    // NIC から受信パケットを取り出す
    rx_pkt = nic_rx();
    // 受信パケットをプロトコルスタックに渡しペイロードを取得
    rx_payload = tcpip_rx(rx_pkt);
    // アプリ固有の処理で応答データを生成
    tx_payload = handle_request(rx_payload);
    // 送信用ペイロードにプロトコル処理を施してパケットにする
    tx_pkt = tcpip_tx(tx_payload);
    // パケットを NIC から送信する
    nic_tx(tx_pkt);
  }
}
これまでの表記に合わせると、CPU コアの設定は以下のようになります。
- CPUコア0 が thread_fn のスレッドを実行する
- CPUコア1 も thread_fn のスレッドを実行する
これで、1)TCP/IP スタックの処理が使わなかった CPU 時間はアプリが使うことができ、その逆も可能である、2)TCP/IP スタックの処理とアプリの処理の間でプロセス・スレッドの切り替えが不要、になります。
lwIP
一方、lwIP という実装は、利用者が1)CPU や OS、既存のライブラリ等への依存度が低く、2)プロトコル処理以外の箇所はあまり隠蔽されておらず、更に、3)lwIP 自体がプロトコルの処理を行うスレッドを実装していないため、個人的に非常に利用しやすく日頃から大変お世話になっているのですが、lwIP は 20 年以上前に小型の組み込みデバイスを想定して設計・実装されていることから、
というようなことがあり、できれば上記の点が解消された実装があれば嬉しいと思っていたため、今回、新しく作ってみることにしました。
今回の実装のポイント
上記のことから、今回は、以下のポイントに注意して実装しています。
- プロトコル処理の実装が特定の CPU、NIC、OS、ライブラリ(DPDK のようなネットワーク I/O 機能実装を含む)、コンパイラ機能に依存しない;プロトコル処理の実装に、標準ライブラリを含む外部のライブラリを利用せず、コンパイラ機能も最低限のものだけを使うようにしました。今回は C 言語で実装しています。
- 外部の実装に対して、隠蔽する機構を最小限にする;外部のライブラリへ依存しないようにすることで、隠蔽の対象はそもそも多くないですが、以下5(NIC とアプリの間でコピーをなくすことができるようにする)のためにパケットバッファの確保・開放機能を内包しない点に注意しています。
- TCP/IP スタック自身がプロトコル処理を実行するスレッドを実装しない;TCP/IP スタック利用者(アプリ開発者)が用意したスレッドの中で定期的に実行されることを想定した関数(API)の中で TCP/IP スタックの処理を実行するようにしました。
- NIC のオフローディング機能を利用できるようにする;NIC とそれを管理するネットワーク I/O 機能は TCP/IP スタック利用者(アプリ開発者)に所属するため、TCP/IP スタック実装利用者に NIC がサポートしているオフロード機能の通知と、それを特定のパケットに対して適用する機能を持ったコールバック関数を実装してもらうようにしました。
- NIC とアプリの間でコピーをなくすことができるようにする;渡されたパケットについて、そのままプロトコル処理を行うようにしました。
- 複数スレッドで同時に実行でき、マルチコア環境で性能がスケールするようにする;過去の実装にあるように (e.g., mTCP (NSDI'14))、各 CPU 上で動作するスレッド間で共有するメモリオブジェクトを作らないようにしました。
性能
簡単に性能を計測してみました。
今回はネットワーク I/O のバックエンドとして、DPDK を利用しました。
環境
2台の同じ以下の設定のマシンを利用
ワークロード
小さいメッセージのやり取りをするワークロード
結果
計測結果は以下のようになりました。目安として Linux カーネルの TCP/IP スタックについても同様のベンチマークを行いました。
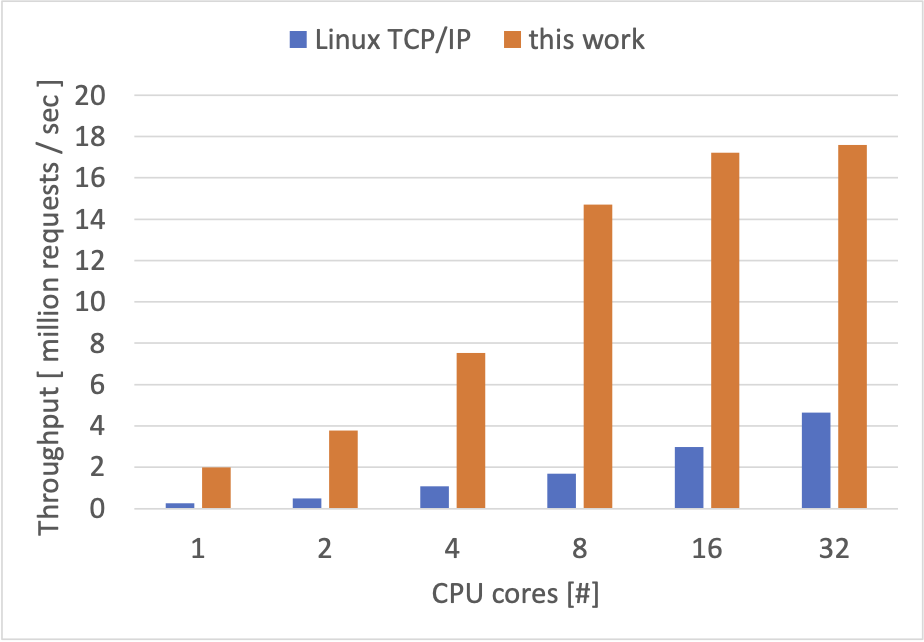
現状では、16 CPU コアまではある程度性能が伸びていく一方、それ以降は 32 CPU コアまで計算リソースを追加しても大幅な性能の改善が見られませんでした。
性能の限界の要因を調査する
16 CPU コア以降性能が大きく向上しない原因について簡単に調べてみようと思いました。
pqos コマンドを使って、CPU・メモリに関する情報を取得してみました。
以下は、それぞれの CPU コアについて得られた結果 ( https://github.com/intel/intel-cmt-cat/wiki/PQoS-monitoring-metrics-definition ) を合計したグラフです。
Instruction Per Cycle (IPC)
IPC は単位時間あたりに処理できた CPU 命令数で、高いほど CPU が効率よくプログラムを実行できているという目安になるようです。
全ての CPU コアの IPC の値の合計を並べてみると、上のスループットの結果と近い傾向が見られました。
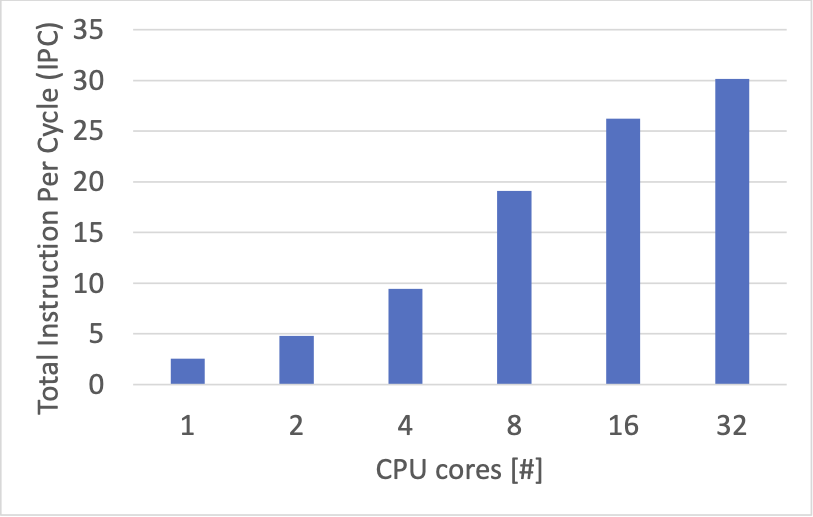
1CPUコア あたりの IPC についてみると、1〜8CPU コアくらいまでは、概ね 2.3 ~ 2.5 くらいで、16 CPU コアで 1.6 くらい、32 CPU コアの時には 0.9 ~ 1.0 くらい、というような感じでした。
Last-level Cache Miss 回数
全ての CPU コアで発生したキャッシュミス回数の合計をプロットすると、以下のようになりました。
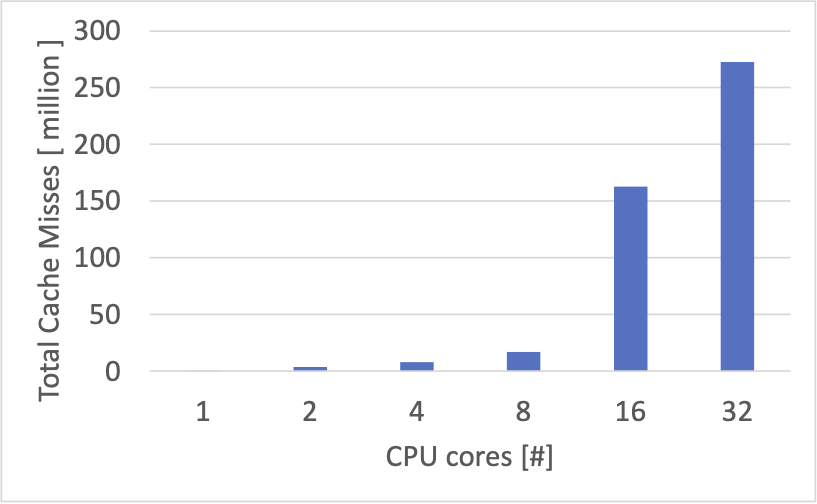
8 CPU コアから 16 CPU コアへかけてキャッシュミス回数が大きく増えているようです。
16 CPU コアからの IPC の低下は、キャッシュミス回数に関係があるかもしれません。
メモリの帯域使用量
各 CPU コアが利用したメモリの帯域の合計をプロットすると、以下のようになりました。
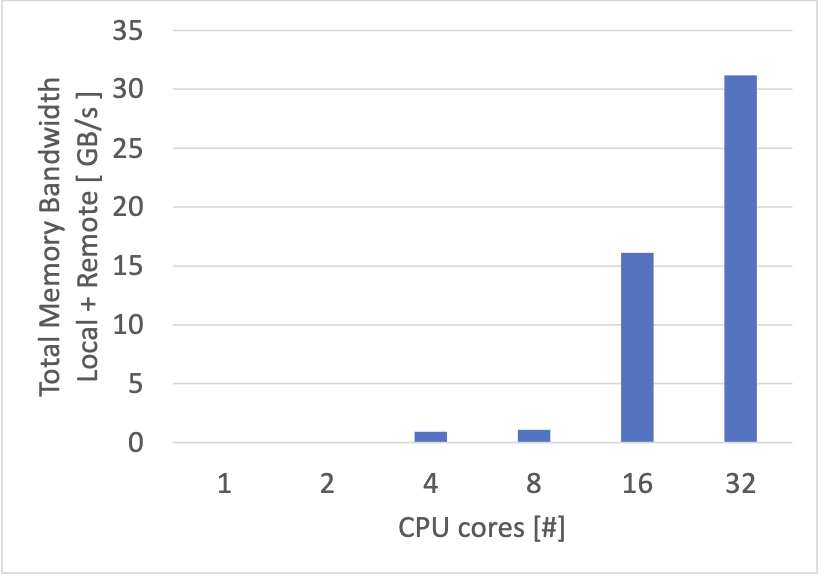
こちらはキャッシュミスの増加にあわせて、8 CPU コアから 16 CPU コアにかけての箇所で大幅な増加が見られます。
キャッシュの占有状況
各 CPU コアが占有しているキャッシュのサイズの合計をプロットすると、以下のようになりました。
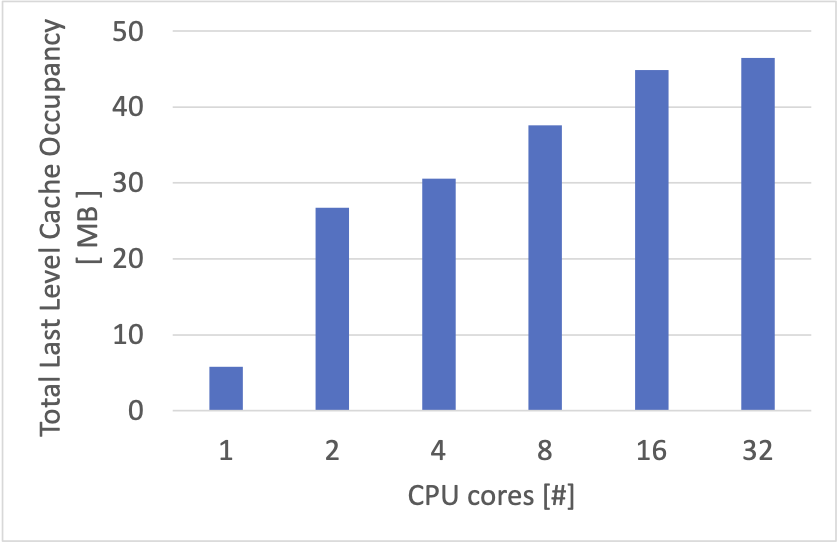
今回使用したマシンの CPU はそれぞれ 24 MB のキャッシュを持っているようなので、2つ合計で 48 MB が上限と思われます。
上のグラフからは、16 ~ 32 CPU コアの場合には、ほぼ全体のキャッシュ容量を使い切っているように見えます。
キャッシュのサイズの影響をもう少しみる
先ほどまでは、2CPU のそれぞれのコアをバランスよく同数利用していたため、合計 48 MB のキャッシュが利用できましたが、今度は、全てのスレッドを1つの CPU の上で動かして計測を行ってみました。この場合、16 CPU コアまで同じコア数でありながら利用可能な最大のキャッシュサイズが 24 MB になるはずです。
以下は、同じ実験のスループットの結果です。(青い 2 CPU の時は、先ほどまでの実験結果と同じです。)
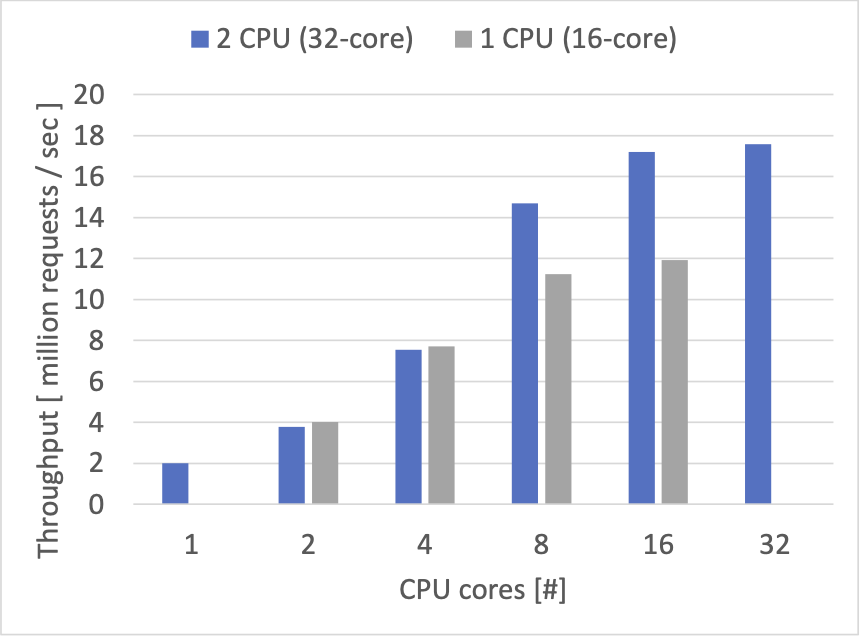
同じ CPU コア数を利用しても、1CPUの時の方が低い性能となりました。
以下は、計測した合計のキャッシュ占有状況です。
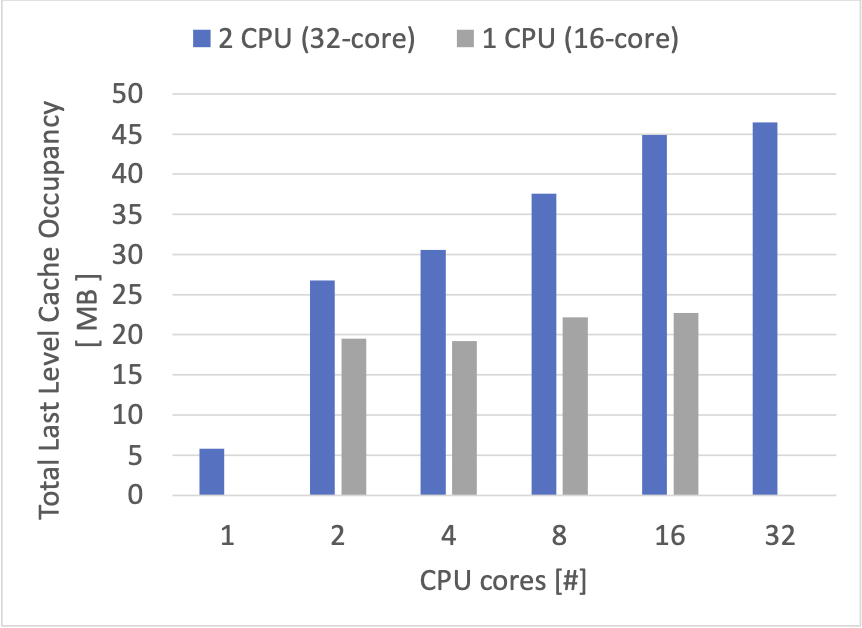
1CPUの場合は合計 24 MB 以下で頭打ちになっています。
性能限界の要因の予想
これ以外にも要因はあると思われますが、16 ~ 32 CPU コアが同時に作業しようとした場合、それら全てが一定時間内に扱うデータ量の合計が、CPU が搭載しているキャッシュのサイズを超えてしまい、結果として、(2CPU利用時)8 CPU コアから 16 CPU コアにかけて、大幅なキャッシュミスの増加とそれに伴うメモリへのアクセスの増加が発生しており、結果としてメモリの読み書き待機のために IPC が低下している、ということを、CPU コア数を増加させても性能が向上しなくなる要因の一つとして予想します。
まとめ
- 他のシステムと統合しやすいくマルチコア環境で利用できることを目指した TCP/IP スタックを作っています。
- 現在の実装は、キャッシュサイズの不足によってマルチコア環境でのスケーラビリティが制限されているのではないかと予想します。
追記 2023/11/07
キャッシュ効率を悪化させているポイントを発見し改善すると性能が 50 million リクエスト毎秒まで向上しました。(前のバージョンは 17.5 million リクエスト毎秒が最大でした。)
以下のグラフは上のものと同じ実験をした結果です。
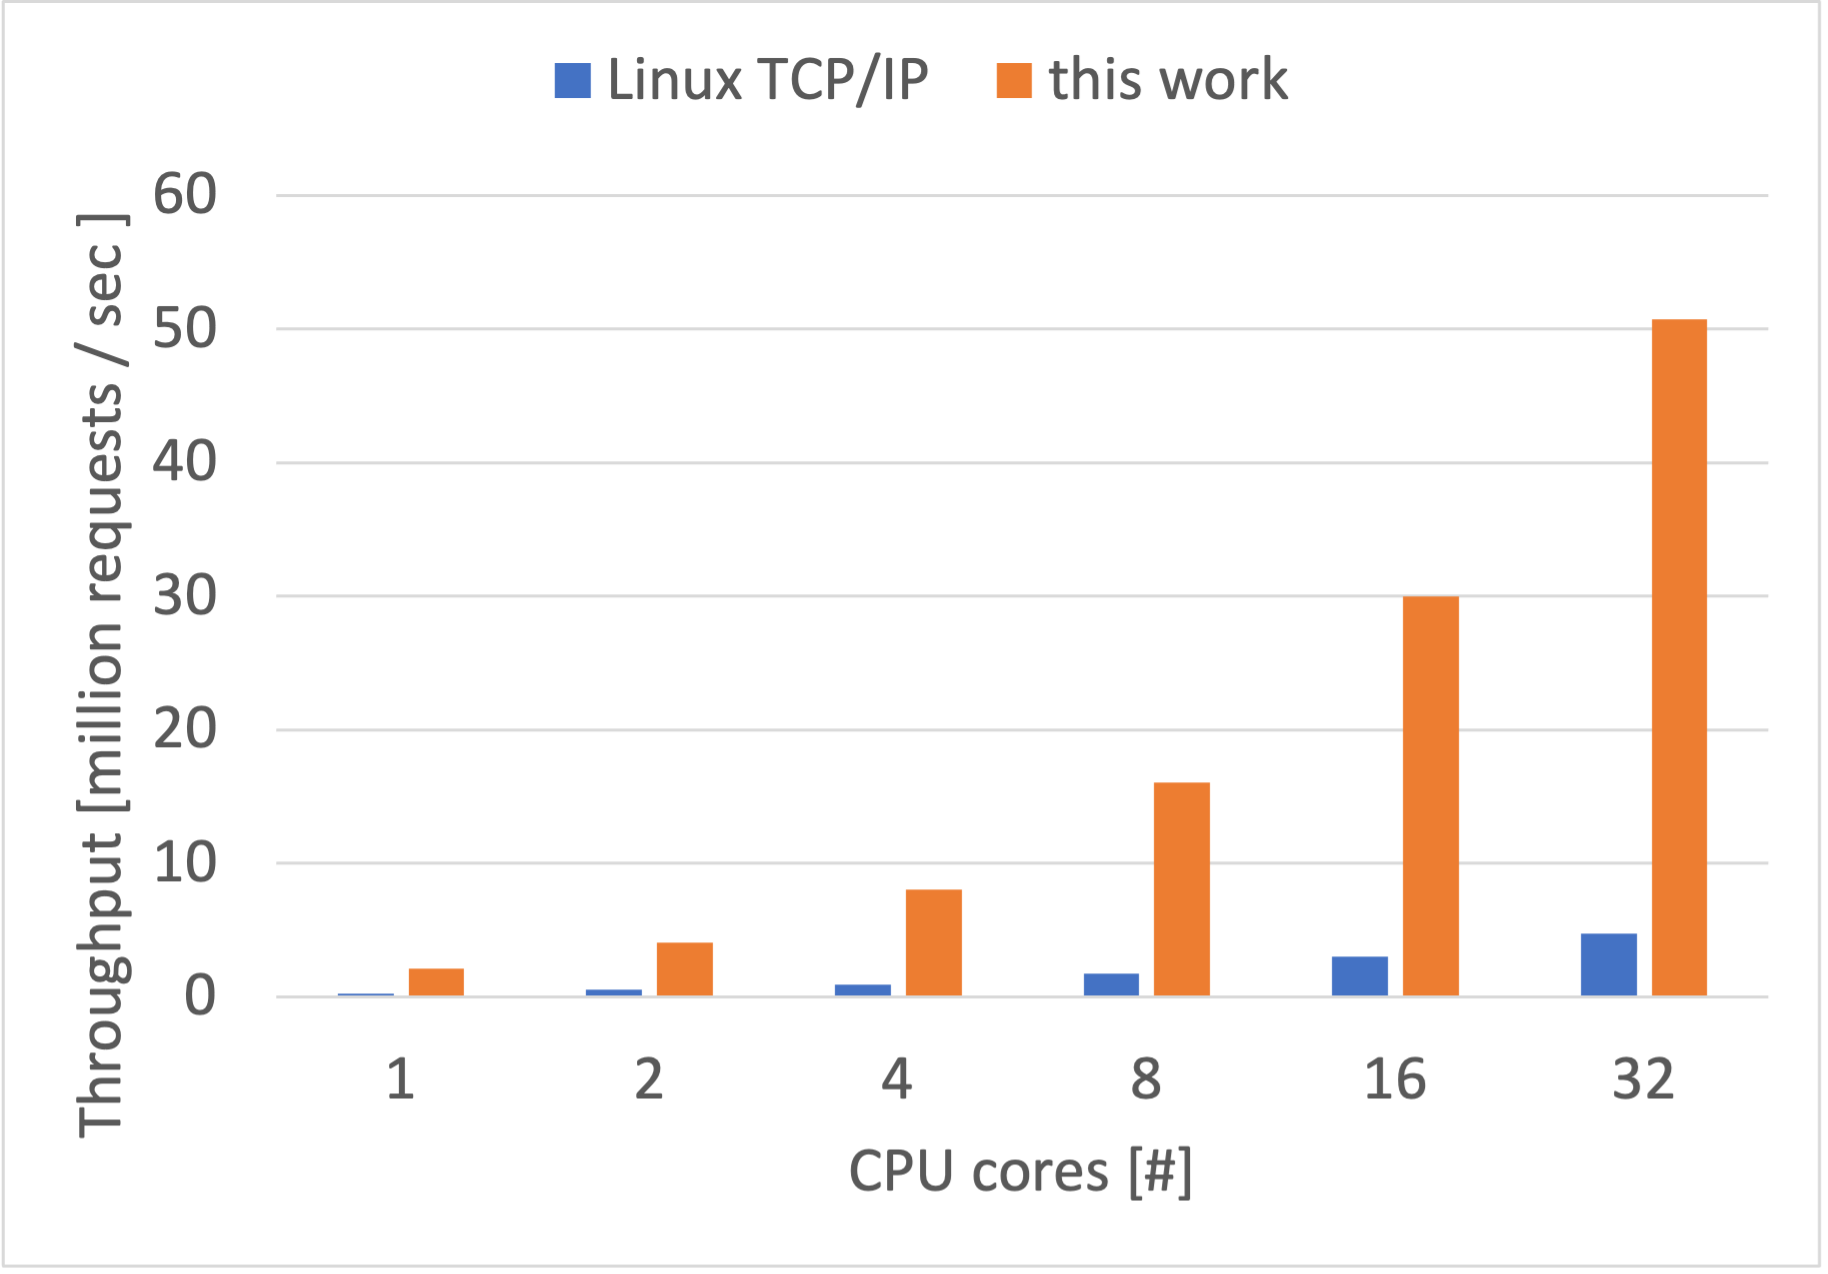
具体的には、TCP/IP スタック実装内でパケットへの参照を保持する Linux で言えば sk_buff のような構造体の確保・開放の方法に、キャッシュ効率悪化の原因がありました。
当初は、この構造体を予め所定の個数 malloc した後、キュー(連結リスト)のようなデータ構造に入れておき、新たに確保したい場合は先頭から取り出し、開放時には最後尾に追加する、というような実装で確保・開放を行なっていました。
ですが、確保・開放を繰り返した場合に、この構造体は先頭から取り出され末尾に追加されることで、ローテーションしてしまうため、結果として、毎回確保時に取り出される先頭のものは多くの場合でキャッシュに乗っていない、ということが原因でキャッシュ効率が低下しているようでした。
このため、この構造体を開放時に末尾ではなく、先頭に追加するようにするだけで、性能が大幅に改善しました。
変更としてはこのパッチにあたります。
OS のメモリ管理の仕組み
OS のメモリ管理の仕組みについて調べたことをまとめました。
読んでいただくと、以下のようなことについて少し詳しくわかるかもしれません。
- あるユーザー空間プロセスが他のユーザー空間プロセスのメモリにアクセスできない理由
- ユーザー空間プロセスがカーネル空間のメモリにアクセスできない理由
- ユーザー空間のプロセスとスレッドの違いはどのように実装できるか
- 共有メモリはどのように実装できるか
- メモリマップトファイルはどのように実装できるか
- malloc は何故必要か
- あるコンテナが別のコンテナのメモリにアクセスできない理由
- コンテナと仮想マシンのメモリ領域の分離についての違い
上記の全ての点について、仮想メモリという一つの機構で概ね説明可能である、というのが今回のポイントです。
また、そもそものユーザー空間プロセスとメモリの関係についても、少しわかるかもしれません。
当記事は、x86-64 CPU で動作する汎用 OS 環境を想定しています。
メモリ
当記事では、Dynamic Random Access Memory (DRAM) についてメモリと呼ぶとします。
メモリは、ハードウェアの仕様上、CPU からアクセス可能な記憶領域で、パソコンには基本的なパーツとして付属しています。
メモリには、各バイト(8-bit)ごとに 0 からメモリの最大容量まで番地(アドレス)が振ってあり、CPU からメモリへのデータの書き出し・読み込みは、アドレスを元に行います。(後述しますが、このアドレスは物理メモリアドレスと呼ばれます。)
CPU からメモリへのアクセスはいつどのように発生するか
まず、プログラムがどのようにメモリを利用しているか、具体的には、メモリへのアクセスがどのように発生するかということについて見ていきます。
前提として、
- CPU はプログラムを実行するハードウェアで、
- CPU はプログラムの実行に際して、メモリ上のデータを読み書きし、そのことをメモリアクセスと当記事では呼んでいます。
今回は例として、以下のような変数 __x と変数 __y を加算した結果を変数 __z に代入するようなプログラムを考えます。
__z = __x + __y
コンピューターで上のプログラムを実行するときの CPU とメモリの状態は以下の図のようになると思われます。
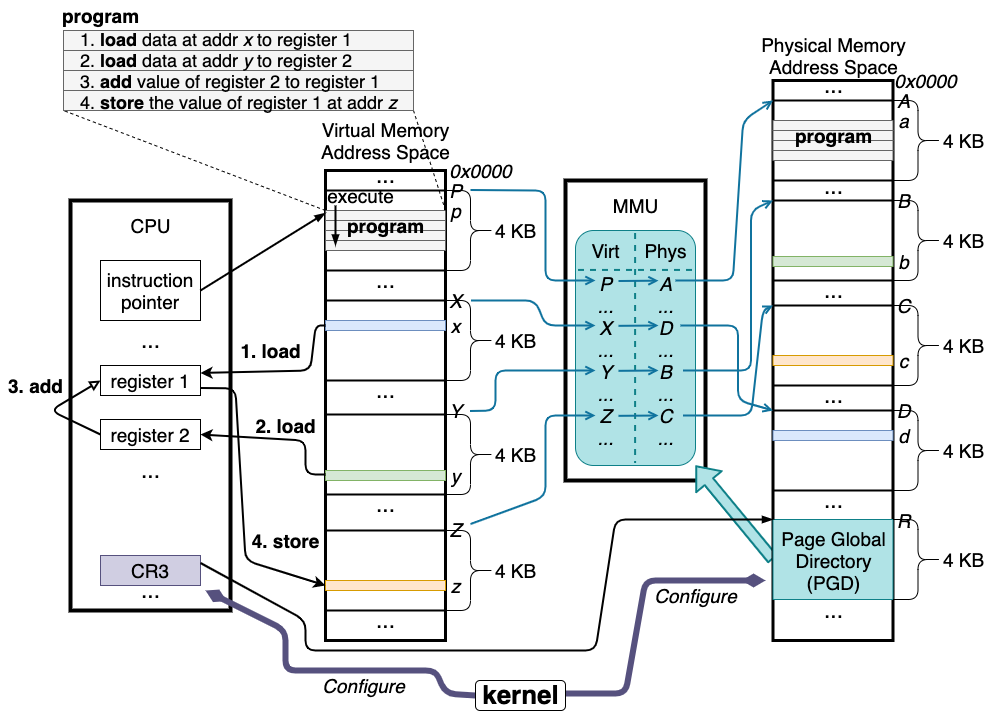
メモリに置かれるデータ
上のプログラムを実行する際には、__x, __y, __z の値と、上のプログラム自体がメモリの上に保存されます。
まず、Virtual Memory Address Space と書いてある箇所に目を向けていただいて、今回の例では、__x はメモリアドレス x、__y はメモリアドレス y、__z はメモリアドレス z、プログラムはメモリアドレス p に保存されるとして見てください。(実際のプログラムでは、__x, __y, __z は比較的近いアドレスに保存されると思いますが、今回は例のため敢えて分散しています。)
CPU 内部のパーツ
次に、図中の CPU 内の要素について見ていただきたいのですが、この図には、
- instruction pointer
- register 1
- register 2
- CR3
が描いてあり、これらはレジスタと呼ばれるパーツで、x86-64 等では、それぞれ 64-bit の値を保持できます。
それぞれの機能についての説明は以下のようになります。
プログラムの挙動
__x + __y = __z を実行するプログラムは、機械語に対応するアセンブリ言語に変換すると、以下のようなになるとします。(コンパイラの出力によっては違う結果になると思われます。)(CPU の仕様上、各命令を実行すると、instruction pointer が自動的にインクリメントされて次の命令が CPU に読み込まれ実行されるようになっています。)
命令 1. メモリアドレス x の値を register 1 へロードする
命令 2. メモリアドレス y の値を register 2 へロードする
命令 3. register 2 の値を register 1 へ加算する
命令 4. register 1 の値をメモリアドレス z へストアする
なぜ単純な足し算がこのような手順を踏む必要があるかというと、それは CPU の仕様によるもので、CPU が実装している加算の命令がレジスタの現在の値を元に加算を行うものしかない場合、このようにわざわざメモリの値をレジスタに読み込んだ後加算する、という操作が必要になります。
上の例におけるメモリアクセスの発生箇所
上のプログラムにおいて、メモリアクセスは、命令 1, 2 のロード(メモリからレジスタへの読み込み)と命令 4 のストア(レジスタからメモリへの書き込み)、さらにはプログラムである命令 1, 2, 3, 4 自体を CPU へ読み込むところで発生しています。
OS・カーネルによる、プログラムのメモリアクセスについての制御の要件
汎用 OS 環境では、プログラムは複数並列で実行されることが一般的ですが、その場合に、複数のプログラムが意図せず同じメモリ領域を利用してしまうことを回避する必要があります。
例えば、上の例のプログラムと一緒に別のプログラムが動作しているとして、例のプログラムは加算結果をメモリアドレス z に保存しますが、その別のプログラムがメモリアドレス z 上に既にデータを保存していたとすると、それは上書きされ、その別プログラムのクラッシュ等につながります。
このようなことを避けるために、汎用 OS・カーネルは、複数のプログラムが意図せず同じメモリ領域へアクセスできないように制御しています。
この制御の根底にある機構が、仮想メモリという仕組みで、今回の記事のポイントです。
仮想メモリ
物理メモリアドレスと仮想メモリアドレス
ここまで特別に区別なくメモリアドレスと記述してきましたが、メモリアドレスには物理メモリアドレスと仮想メモリアドレスがあります。
物理メモリアドレスは、ハードウェアのメモリの中で、各バイト(8-bit)ごとに割り当てられている番地です。
一方、仮想メモリアドレスは、ソフトウェアが制御可能な仮想的なメモリアドレスで、あるプログラムが(仮想)メモリアドレス N にアクセスしているつもりでも、実は物理メモリアドレス M にアクセスさせる、というようなことができます。
x86-64 のような CPU を採用しているコンピューターで通常利用されるプログラムは、仮想メモリアドレスをもとに動作しており、この仮想メモリ機構がカーネルが行うメモリ管理の基本的な仕組みとなっています。
上のプログラムの例にあるメモリアドレス x, y, z, p は、仮想メモリアドレスとなります。
Memory Management Unit (MMU)
「プログラムが(仮想)メモリアドレス N にアクセスしているつもりでも、実は物理メモリアドレス M にアクセスさせる」というようなことができる仮想メモリ機構はどのように実現されるか、ということについて見ていきます。
基本的に、仮想メモリ機構の実現は Memory Management Unit (MMU) というハードウェアの機能に依存しています。
上の図の通り、MMU は CPU とメモリの間に位置し、CPU のメモリアクセスを仲介します。
この仲介に際して、MMU は、
- ソフトウェアがメモリ上に作成可能なページテーブルと呼ばれる(ハードウェア仕様によりフォーマットが定義された)仮想メモリアドレスと物理メモリアドレスの対応を保持するデータ構造を参照し、
- CPU がアクセスしようとしたメモリアドレス(これを仮装メモリアドレスとします)を、ページテーブルに保持されている対応の通りに、物理メモリアドレスへのアクセスへと変換します。
ページテーブル
ページテーブルは、4KB 単位(ページと呼ばれます)で仮想メモリアドレスと物理メモリアドレスの対応を保持するようになっており、上の図の例では、以下のような対応が保持されています。
| 仮想アドレス | 物理アドレス |
| P | A |
| X | D |
| Y | B |
| Z | C |
MMU のアドレス変換に際しては、4KB のページ単位での変換の上、4KB より小さい粒度はオフセットとして加算されます。例えば、上の図では、プログラムは仮想メモリアドレス p に存在し、MMU によって、まず4KB 単位の変換、仮想メモリアドレス P から物理メモリアドレス A に変換されたのち、オフセット (p - P) が A に加算され、(今回の図では (p - P) は (a - A) と同じとして見てください)仮想メモリアドレス p へのアクセスは物理メモリアドレス a へのアクセスに変換されます。
また、「1. メモリアドレス x の値を register 1 へロードする」の操作の場合、実際には、プログラムが x という仮想メモリアドレスへアクセスしようとしたところ、MMU がそれを物理メモリアドレス d へのアクセスへ変換します。((x - X) は (d - D) と同じとして見てください。)
「2. メモリアドレス y の値を register 2 へロードする」は、実際には MMU での変換により、物理メモリアドレス b からの読み込みになります。((y - Y) は (b - B) と同じとして見てください。)
ちなみに、4KB のページ単位で変換を行うと書いてきましたが、ハードウェアとしては2MB、1GB 単位の対応の記述もサポートしており、Linux 等では Huge Page という機能で利用可能です。
ページテーブルのフォーマット
先述の通り、ページテーブルはハードウェアで定義された構造で、ソフトウェアはそれに合わせてメモリ上にデータを用意します。
ページテーブルのフォーマットについては若干実装に寄りすぎるため、ページテーブルが、ソフトウェアがメモリ上に作成可能なデータ構造である、という認識をしていただけたら読み飛ばしていただいても大丈夫と思います。
具体的には、以下の図のように4段の木構造のようになっており(5段もサポートされる場合があります)、仮想メモリアドレスをキーとして、物理メモリアドレスをバリューとするキー・バリューを保持するデータ構造として見ることができます。
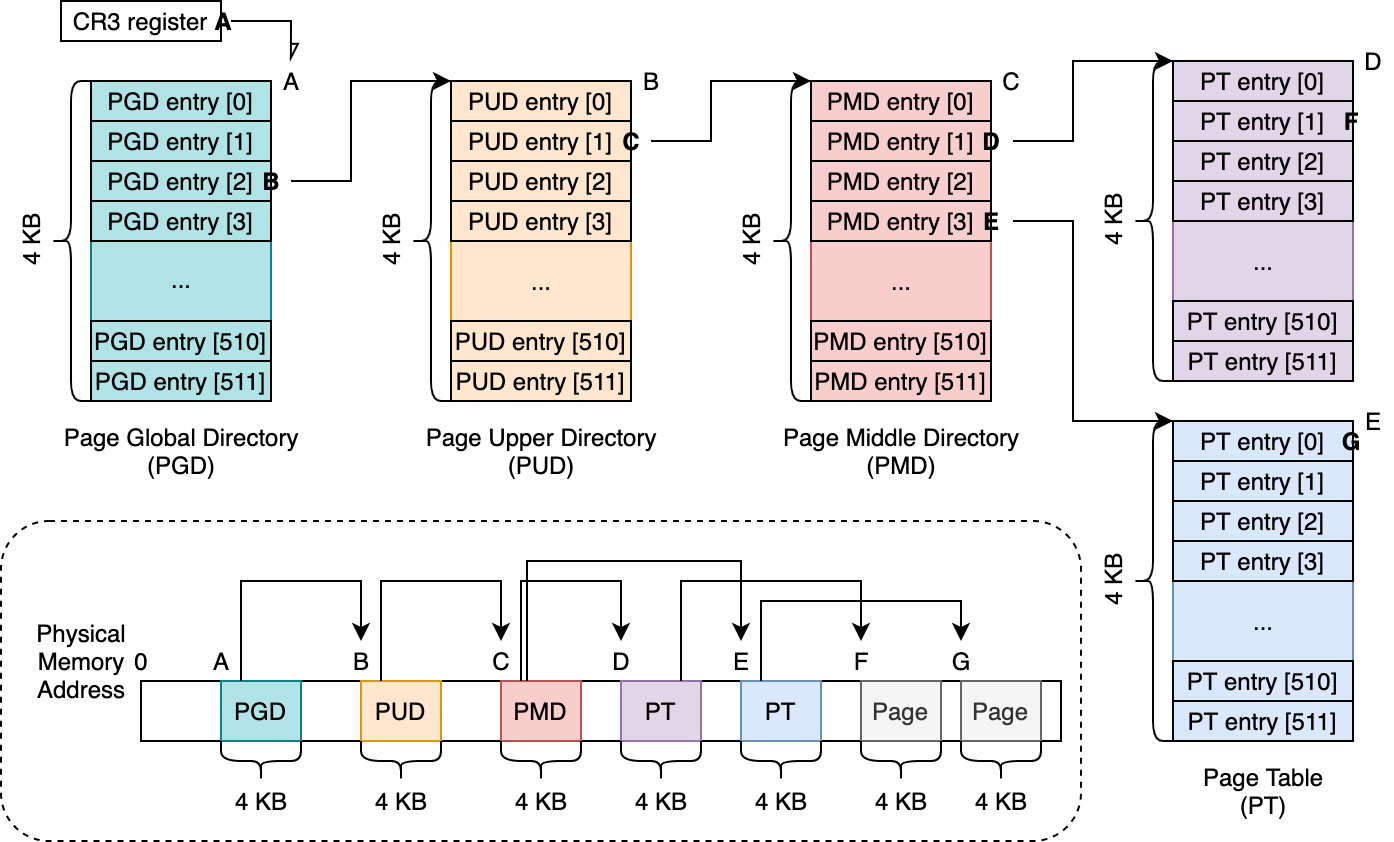
4段の各層には名前がついており、Linux 等ではそれぞれ、
- Page Global Directory (PGD)
- Page Upper Directory (PUD)
- Page Middle Directory (PMD)
- Page Table (PT)
と呼称され、これら全ての構成要素は4KB のページとなっており、8バイトのエントリーを最大 512 個保持します。(それぞれ8バイトの最大 512 要素が持てる配列として捉えられると思います。)ここで、各エントリーは、次の層の4KB ページの先頭の物理メモリアドレスです。また、それら各エントリーは、その参照先の物理メモリアドレスに加え、フラグとして、書き込み可能・不可能等の設定が可能になっています。
上の図の例を使って、具体的にどのように仮想メモリアドレスに対応する物理メモリアドレスをどのように登録するか見ていきます。
先に書くと、上の図では、2つの4KB ページについての対応が保持されています。
| 仮想アドレス | 物理アドレス |
| 0x10040201000 | F |
| 0x10040600000 | G |
仮想メモリアドレス 0x10040201000 に対して、物理メモリアドレス F を対応させるには、以下のような手順をたどります。(以下、512 GB == (1 << 39), 1 GB == (1 << 30), 2 MB == (1 << 21), 4 KB == (1 << 12) として見てください。)
- まず、ページテーブルを辿るときの探索開始位置である PGD の 512 個保持可能なエントリーのどこを見るべきか考えます。
- PGD の各エントリーは、それぞれ仮想メモリ領域の 512 GB ごとに対応しており、0x10040201000 / 512 GB = 2 となるので(0x10040201000 は 10 進数で 1 TB とちょっとくらいです。)、PGD entry [2] を対象の参照位置とします。(仮に、対応を設定したい仮想メモリアドレスが 512 GB より小さければ、PGD entry [0]、512 GB から 1 TB の間であれば、PGD entry [1] が対象になります。)(これらの値は、実装では割り算ではなくて、ビットマスクで算出することが多いと思います。あと、この例では仮想メモリアドレスが 256 TB (512 GB x 512) より小さいとして見てください。)
- ここで、(ページテーブルを実際に作っていっている時のことを想定して)PGD entry [2] に既に値が入っている場合は、その値を元に次の層である PUD を辿り、逆に値がない、つまり PUD への参照がまだ登録されていない場合は、新しく4KB のページを確保し、その4KB のページの物理メモリアドレスを PGD entry [2] へ入れます。
- 上の図では、物理メモリアドレス B に用意された(今回はメモリアロケータを呼び出したら、たまたま物理メモリアドレス B の4KB ページをくれた、という感じをイメージしてください) PUD を、PGD entry [2] から参照するようになっています。
- PUD の各エントリーは、512 GB より小さい、1GB の粒度で次の層に対応する PMD への参照を保持します。ここで、PGD の時と同じように、0x10040201000 のために PUD が保持可能な 512 個のエントリーのどこを参照の対象とすべきか考えます。
- 計算として、(0x10040201000 % 512 GB) / 1 GB = 1 となるので、PUD entry [1] を対象とします。
- ここでも、PGD の時と同じく、PUD entry [1] に参照の値がない場合は、新しく PMD として利用するために4KB ページを確保して、その物理メモリアドレスを代入します。逆に、すでに値が入っている場合は、それを元に次に辿るべき PMD を見つけます。上の図の例では、物理メモリアドレス C の PMD を辿ります。
- ここまで来ると繰り返しで、PMD の各エントリーは2MB 単位の粒度で次の層への参照を保持します。
- 0x10040201000 の参照のために見るべき PMD のエントリーは、(0x10040201000 % 1 GB) / 2 MB = 1 となるので、PMD entry [1] から次の層である PT への参照を辿ります。上の例では、物理メモリアドレス D です。
- PT の各エントリーは4KB ごとのページに対する参照を保持します。ページテーブルの構成としては、ここが終端です。
- 0x10040201000 については、(0x10040201000 % 2 MB) / 4 KB = 1 なので、PT entry [1] が対象になります。
- 最後に、今回の目的であった、0x10040201000 に対応させたい物理メモリアドレス F を(物理メモリアドレス D の) PT entry [1] に入れます。
仮想メモリアドレス 0x10040600000 に物理メモリアドレス G を対応させるには、
- 0x10040600000 / 512 GB = 2 : PGD entry [2] => 物理メモリアドレス B の PUD を参照
- (0x10040600000 % 512 GB) / 1 GB = 1 : PUD entry [1] => 物理メモリアドレス C の PMD を参照
- とここまで、仮想メモリアドレス 0x10040201000 と同じで、
- (0x10040600000 % 1 GB) / 2 MB = 3 なので、PMD entry [3] を参照の対象とします。(0x10040201000 の時は (0x10040201000 % 1 GB) / 2 MB = 1 だったので、PMD entry [1] を辿っていました。)今回の例では、物理メモリアドレス E の PT への参照が入っています。
- 最後に、(0x10040600000 % 2 MB) / 4 KB = 0 なので、(物理メモリアドレス E の)PT entry [0] に物理メモリアドレス G を代入します。
このフォーマットに沿ってソフトウェアでページテーブルを用意してハードウェアに登録すると、CPU からのメモリアクセス時に、そのページテーブルに保持された仮想・物理メモリアドレスの対応に則ってアドレス変換を行ってくれます。
また、PGD の1エントリが 512 GB への対応となっており、それが最大 512 保持可能なことから、256 TB (512GB x 512) が基本的に最大の仮想メモリアドレス空間となります。
ページテーブルの適用
上のフォーマットに合わせて用意したページテーブルを MMU に適用するためには、x86 CPU では、CR3 レジスタに、PGD の先頭の物理メモリアドレスを設定することで行います。上のページテーブルの例の図では、CR3 レジスタに値 A を入れます。(最初の図の例では、CR3 レジスタに値 R を入れます。)
言い換えると、CPU のメモリアクセスに際して、仮想メモリアドレスから物理メモリアドレスへの変換は、CR3 が参照している PGD を起点として構成されているページテーブルに保持されている対応を元に行われる、ことになります。
カーネルによる、非特権モード時のメモリアクセスの制限
ここで一点、重要なこととして、CPU の仕様上、CR3 レジスタへの値の書き込み操作は、特権命令によってのみ行うことが可能である、ということがあります。つまり、非特権モードで動作する、カーネルでないプログラムから CR3 の値を変更することはできません。
この仕様を利用して、特権モードで動作するカーネルは、特定の非特権モードで動作するプログラムがアクセス可能な物理メモリ領域を、ページテーブルの設定を通じて制御することができます。
ポイントは、仮想メモリアドレスを基準に動作するプログラムのメモリアクセスは全て MMU に仲介されるため、非特権モードで動作するプログラムはどう頑張っても MMU が参照するページテーブルに登録されていない物理メモリアドレスへアクセスすることができないところです。(ページテーブルとして利用している物理メモリ領域を非特権モードのプログラムがアクセス可能なように設定にしない、というのが前提になります。)
ユーザー空間プロセスとメモリ管理の関連
汎用 OS は、複数プログラムが一つのコンピューターのリソースを共有しながら利用できるように作られており、その根底にプロセスという抽象的な概念があります。
プロセスとは何であるかを説明するのは難易度が高い気がしますが、プロセスは、プログラムの実行の単位で、リソース割り当ての対象である、というのが遠からずという感じがします。
このリソースとしてわかりやすいところでは、1つの CPU で複数のプログラムが並列で動作する場合、一定時間ごとに実行されるプログラムが切り替わっている(この辺りはよろしければ過去の記事をご参照ください)のですが、この各プログラムの実行のために割り当てられる CPU の実行時間が一つのリソースと言えます。また、物理メモリ領域も同じくプログラムごとに割り当てられるリソースです。
一つのプログラムが動作するためには CPU 時間やメモリ領域等の複数種類のリソースを利用する必要があり、カーネルがそれらリソースをプロセスという単位にまとめて紐づけている、という見方ができそうな気がします。この抽象化の方法によって、例えば、単位時間あたりにたくさんの CPU 時間とメモリ容量を使えるプロセスと、少ししか使えないプロセスのような区別ができるようになります。
また、カーネルが意図した以上のリソースを、プロセスが使えないようにするポイントが、通常のプロセスが非特権モードで動作し、先述の CR3 アクセスにあるようなリソース管理に関わる操作ができないようになっている点で、当記事では、この非特権モードで操作するプロセスをユーザー空間プロセスと呼称しています。
ということで、汎用 OS 環境で、プログラムへの物理メモリ割り当ては、ユーザー空間プロセス単位で行われますが、先述の通り、カーネルはプログラム間でメモリアクセスが干渉しないように配慮する必要があり、このためにカーネルは、あるユーザー空間プロセスが、他のユーザー空間プロセスに割り当てられたメモリに基本的にアクセスできないようにしています。
この OS・カーネルが行うユーザー空間プロセス単位でのメモリ管理を可能にしているのが、ここまでで述べてきた仮想メモリ機構です。
最初の疑問へ戻る
あるユーザー空間プロセスが他のユーザー空間プロセスのメモリにアクセスできない理由
この、あるユーザー空間プロセスが他のユーザー空間プロセスのメモリにアクセスできない、という挙動の実装は、
- カーネルは、ユーザー空間プロセス1つごとに、独立した1つのページテーブルを作成し割り当て、
- カーネルが、1つの物理メモリ領域が、1つのユーザー空間プロセスのページテーブル以外に登録されないように注意する(先述の、仮想メモリアドレスを基準に動作し、メモリアクセスが全て MMU に仲介されるプログラムは、適用されているページテーブルに登録されていない物理メモリ領域へどう頑張ってもアクセスできない、というのがポイントです。)、
ことで達成できます。
このため、汎用 OS 環境では、一般的に各ユーザー空間プロセスが独立したページテーブルを持っており、プロセススケジューラーによって、プロセスが切り替わるタイミングで CR3 の値を書き換え、そこから実行され始めるプロセスのページテーブルを MMU に適用するすることで仮想メモリ領域を切り替えています。
図にすると以下のようになると思われます。
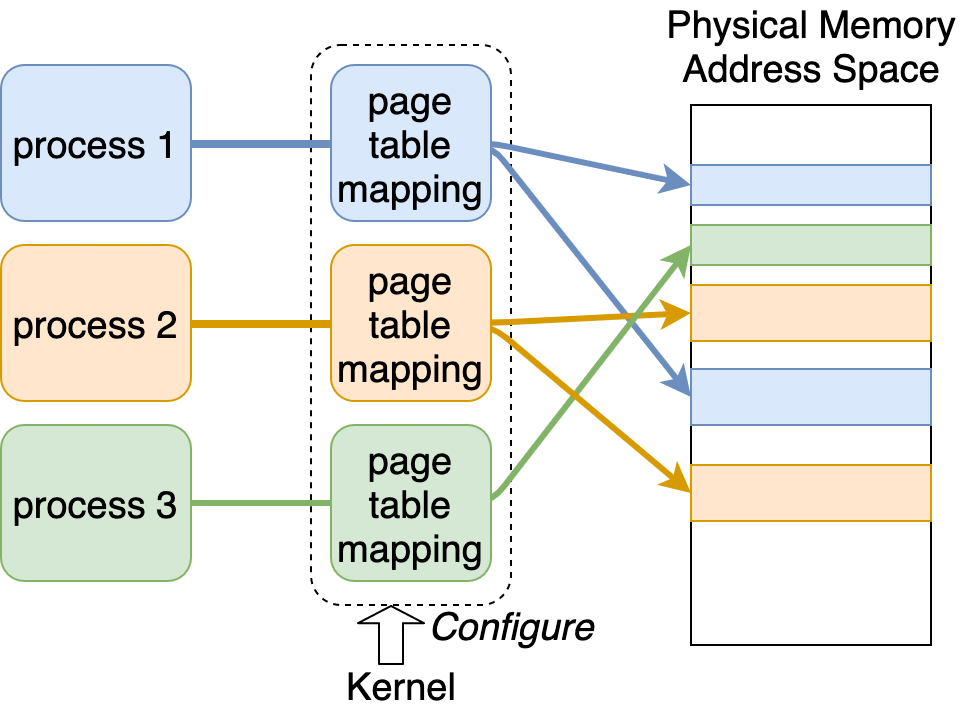
この図では、process 1, 2, 3 が別々のページテーブルを持ち、それぞれについて、カーネルが仮想メモリアドレスと物理メモリアドレスの対応 (page table mapping) を設定しており、例えば、process 1 は、そのページテーブルに物理メモリ領域の参照が登録されてる青い物理メモリ領域しかアクセスできず、別のプロセスに属しているオレンジと緑の物理メモリ領域、また空白(白い)物理メモリ領域にはアクセスできません。更に、カーネルが気をつけて、この青い物理メモリ領域への参照を他のプロセスのページテーブルに登録しないようにすることで、今回の例であれば、process 2, process 3 から、process 1 が利用している青い物理メモリ領域へアクセスできなくなっています。
ユーザー空間プロセスがカーネル空間のメモリにアクセスできない理由
カーネルは、カーネルが利用する物理メモリ領域(つまりカーネル空間のメモリ)への参照をユーザー空間プロセスのページテーブルに登録しないようにすることで、そのユーザー空間プロセスは、カーネル空間のメモリにアクセスできないようにできます。
また、ページテーブルには各4KB ページごとに特権モードでないとアクセスできない、という設定をすることが可能ですが、Meltdown のようなサイドチャネル攻撃の影響を受けるため、最近ではユーザー空間プロセス実行時に利用されるページテーブルは、大部分のカーネルの利用する物理メモリ領域への参照を持たないようになっているようです。これは Kernel Page Table Isolation (KPTI) というような名前で呼ばれるようです。
ユーザー空間のプロセスとスレッドの違いはどのように実装できるか
ユーザー空間のプロセスとスレッドの違いは(Java や Python のような言語のランタイムではなく OS レベルにおいて)、プロセス間はメモリ領域が分離されている一方で、同一プロセス内で生成されたスレッド間ではメモリ領域を共有する、というものがあります。
スレッド間で、全く同じメモリ領域を共有する、という挙動は、それらスレッドで同一のページテーブルを共有することで実現できます。具体的には、同一プロセス内で生成されたスレッドが実行される時には、CR3 が同一の PGD を参照する、ようにします。
図にすると以下のようになります。
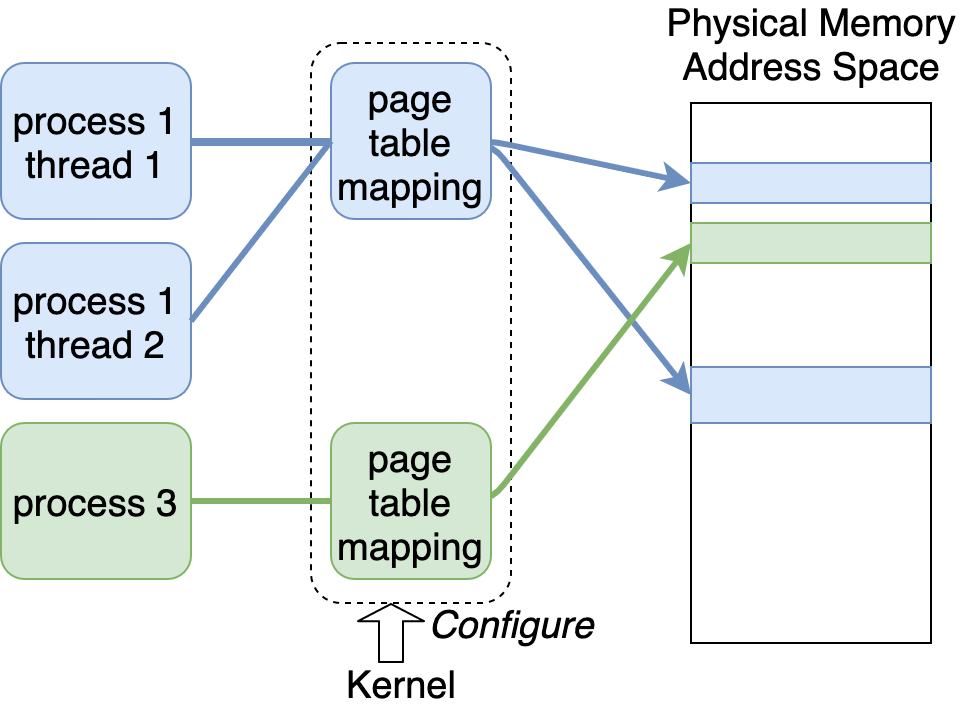
この図では、process 1 に属する thread 1 と thread 2 が同一のページテーブルを共有しています。これにより、これら thread 1, 2 は MMU によるアドレス変換を通じて、全く同じ物理メモリ領域にアクセスできます。
実装としては、Linux でいう task_struct のようなプロセス・スレッドを表す構造体に CR3 が参照すべき PGD の値を保持するフィールドを用意し、プロセス切り替え時にその値を CR3 に適用していくようにしておくとともに、同一プロセス内で生成されたスレッドの task_struct の参照する PGD の値は全て同じになるようにする、というような方法が考えられると思います。(スレッド生成時に、新しくページテーブルを作成せず、スレッド生成元のプロセスと同じページテーブルを使う、という感じで良いと思います。)
共有メモリはどのように実装できるか
共有メモリは、異なるユーザー空間プロセス間、もしくは、カーネルと特定のユーザー空間プロセス間で作成可能です。
異なるユーザー空間プロセス間で共有メモリの作成は、それぞれのユーザー空間プロセスのページテーブルに、同一の物理メモリ領域への参照を登録することで実装可能です。
図にすると以下のようになると思われます。
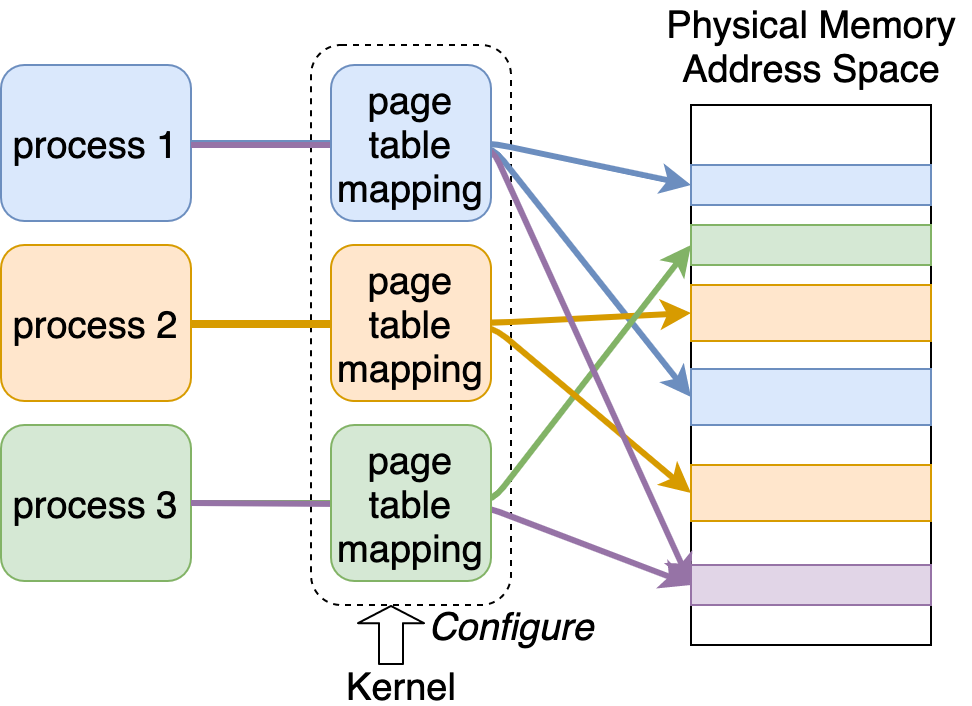
上の図で、紫の物理メモリ領域が process 1 と process 3 にとっての共有メモリになります。これは、カーネルが process 1 と process 3 のページテーブル両方に、この紫の物理メモリ領域への参照を登録することで実現できます。
同じく、カーネルと特定のユーザー空間プロセス間の共有メモリは、カーネル実行中に適用しているページテーブルとそのユーザー空間プロセスのページテーブルの中に、同一の物理メモリ領域への参照を登録することで作成できます。
メモリマップトファイルはどのように実装できるか
ファイルをユーザー空間プロセスのメモリ領域に貼り付けるメモリマップトファイルは、基本的に、カーネルとユーザー空間プロセス間の共有メモリとして実装可能です。
具体的には、通常カーネル空間からのみアクセスできるようになっている、ファイルシステムのページキャッシュとして利用している物理メモリ領域の参照を、特定のユーザー空間プロセスのページテーブルに登録します。
malloc は何故必要か
malloc はユーザー空間に実装されるライブラリコールで、引数に確保したい連続的なメモリ領域のサイズを取り、アプリケーションの呼び出しに応じてメモリの割り当てを行います。
malloc は呼び出された裏側で、必要があれば brk や mmap のようなシステムコールを呼び出し、カーネルに物理メモリの割り当てを要求します。
ユーザー空間のプログラムが基本的に mmap 等を直接利用してメモリを確保しない理由の一つは、メモリ確保の粒度で、ページテーブルの仕様から、カーネル空間からユーザー空間プロセスへの物理メモリ割り当ては4KB 単位となり、それより小さい例えば 100 バイトくらいの領域の確保ごとに4KB を割り当てていると無駄が多い、というのがあると思います。
一方、malloc は、カーネルから4KB 単位で確保した領域から、4KB より小さい領域を切り出してアプリケーションのリクエストに対してメモリの割り当てを行うため、メモリの利用効率が高くなります。
さらに、もう一点は、brk や mmap はシステムコールであるため呼び出しに比較的時間がかかる一方、malloc はライブラリコールであり、追加で brk や mmap の呼び出しが不要の場合は、システムコールを呼び出すより高速である、という利点もあります。
あるコンテナが別のコンテナのメモリにアクセスできない理由
コンテナ間のメモリの分離は基本的に、先述のユーザー空間プロセス間のメモリの分離と同じ仕組みで、カーネルがそれぞれのコンテナ内で動作するページテーブルが同一の物理メモリ領域を参照しないように気を付けているため、あるコンテナは別のコンテナのメモリ領域にアクセスできないようになっています。
コンテナと仮想マシンのメモリ領域の分離についての違い
仮想マシン環境では、Intel VT-x のような仮想化支援のための CPU 機能を利用する場合、
- ゲスト仮想マシンから見える物理メモリアドレス領域自体も先述の仮想メモリアドレスのように仮想化されており、
- ホストは、ゲスト物理メモリアドレスとホスト物理メモリアドレスの対応を保持する Extended Page Table (EPT) とよばれるページテーブル(EPT も通常のページテーブルと同じくハードウェア仕様でフォーマットが決まっており、概ね通常のページテーブルと同じ形式です)をメモリ上に用意し、
- それを仮想化支援機能機構に登録する(EPT の登録は CR3 への書き込みではなく Virtual Machine Control Structure (VMCS) の特定のフィールドに EPT の (PGD と同じような) 参照開始位置のホスト物理メモリアドレスを書き込むことで行います)ことで、
- ゲスト仮想マシンからのホスト物理メモリ領域へのアクセスを制御します。
仮想マシンがアクセス可能な物理メモリ領域の分離は、ホストが異なる仮想マシンの EPT に、同一の物理メモリ領域への参照を登録しないように気をつけることで実現できます。
なので、コンテナは、通常の CR3 へ登録するページテーブルによってメモリアクセスが分離される一方、仮想マシンは、VMCS のフィールドを通して登録する EPT によってメモリアクセスが分離されている、という点が違う、といえるかもしれません。
ただ、分離の基本的な仕組みは両方同じで、1つの物理メモリ領域への参照を、(コンテナの場合)異なる複数のコンテナのプロセスのページテーブルに登録しない、(仮想マシンの場合)異なる複数の仮想マシンの EPT に登録しないようにする、ことなので、本質的に分離の機構に大きな差はないと言えるかもしれません。
一方、コンテナと仮想マシンが大きく異なる点は、同一マシンで実行されるコンテナ全てが単一のカーネルにホストされるのに対し、仮想マシン環境では、それぞれの仮想マシンインスタンスごとに1つのカーネルが動作し、ある仮想マシン上で動作するカーネルは、他の仮想マシン上で動作するカーネルとメモリ領域を共有していない、という点であると思われます。
この差異による問題として、カーネル内のコンテナのための分離機能でバグがあることがあるらしく、結果として、カーネルを共有しない仮想マシンの方が分離の強度が高いと言われる所以となっていると思われます。
まとめ
- 汎用 OS 環境ではプログラムは基本的に仮想メモリアドレスを元に動作する
- 仮想メモリ機構は、MMU という CPU がアクセスしようとした(仮想)メモリアドレスを物理メモリアドレスへのアクセスへ変換するハードウェアの機能に依存している
- MMU の仮想メモリアドレスから物理メモリアドレスへの変換は、ソフトウェアから、ページテーブルの用意と CR3 へのレジスタへの設定によって操作可能である
- CPU の仕様上、 CR3 の操作が非特権モードで動作するユーザー空間プロセスに許可されていないことを利用して、カーネルは特定のユーザー空間プロセスがアクセス可能な物理メモリ領域をページテーブルの設定を通じて行うことができる
- ページテーブルの設定により、ユーザー空間プロセス間のメモリアクセスの分離、プロセスとスレッドの違い、共有メモリ、メモリマップトファイル等の実装が可能である
その他補足
ページフォルト
ページテーブルには必ずしも全ての仮想メモリ領域( 256 TB )について物理メモリページへの参照を登録する必要はありません。
仮に、プログラムが物理メモリページへの参照が登録されていない仮想メモリアドレスへのアクセスがあった場合には、ページフォルトと呼ばれる CPU 例外が発生し、通常 OS・カーネルが事前に登録しているページフォルトハンドラに処理が移行します。
物理メモリページへの参照が登録されていない仮想メモリアドレスへのアクセスによるページフォルトは、C 言語等でプログラムを書いているとよく見るセグメンテーションフォルトと呼ばれる違反の原因の一つだったりします。
デマンドページング
物理メモリページへの参照が登録されていない仮想メモリアドレスへのアクセスによってページフォルトが発生した時に、OS・カーネルは、ページフォルトハンドラの中で、該当する仮想メモリアドレス領域に新しく物理メモリページへの参照を追加したのち、ページフォルトを起こしたプログラムへ処理を戻すこともできます。この場合、特に問題がなければそのプログラムは続けて動き続けることができます。
この特性を利用して、プログラムが実際にアクセスして利用を開始するまで、物理メモリページへの参照をページテーブルに登録しない、つまり、物理メモリ領域をプログラムのために割り当てない、という操作を行うことも可能で、これはデマンドページングと呼ばれるそうです。
OS・カーネルにメモリ確保をリクエストするインターフェース
汎用 OS 環境で、物理メモリページへの参照が登録されていない仮想メモリアドレスへのアクセスによってページフォルトが発生した時に、セグメンテーションフォルトとしてプログラムを停止するか、物理メモリ領域への参照をページテーブルに追加して、処理をプログラムへ戻すかは、事前にそのプログラムが該当する仮想メモリ領域への物理メモリ割り当てを OS・カーネルにリクエストしていたかどうか、ということによる場合が多いと思われます。
UNIX 系 OS では、mmap のようなシステムコールで、ユーザー空間プロセスはカーネルに対して、物理メモリ割り当てを要求できます。
mmap システムコールは引数の一つとして、割り当てて欲しいメモリのサイズを取り、戻り値として、仮想メモリアドレスを返します。
この結果、mmap システムコールを実行したユーザー空間プロセスは、「戻り値で受け取った仮想メモリアドレス」から「戻り値で受け取った仮想メモリアドレス + mmap に割り当てて欲しいメモリのサイズとして渡した値」までの仮想メモリ領域へは、カーネルが物理メモリへの参照をページテーブルに登録してくれることが(基本的に)保証されます。
一方、カーネルは mmap システムコール実行時に、必ずしもこの物理メモリ領域への参照をページテーブルに登録する必要はなく、ページテーブルには触らないで、戻り値となる仮想メモリアドレスを決めて、それを返すだけにすることもできます。この場合、ページフォルト発生時に、ページフォルトハンドラ内で、フォルトが発生した仮想メモリアドレスを確認し、それが mmap システムコールを通して、ユーザー空間プロセスに対して物理メモリの割り当てを約束した仮想メモリ領域であれば(上の mmap の結果「戻り値で受け取った仮想メモリアドレス」から「戻り値で受け取った仮想メモリアドレス + mmap に割り当てて欲しいメモリのサイズとして渡した値」までの仮想メモリ領域であれば)、該当する仮想メモリ領域のページテーブルのエントリーに物理メモリ領域への参照を追加し、処理をユーザー空間プロセスへ戻すような、デマンドページングの方式を採用することができます。(この機能のためには、カーネルは、ユーザー空間プロセスのどこの仮想メモリアドレス領域に物理メモリの割り当てを約束したかを記録しておく必要があると思われます。)
dlmopen を使ってシステムコールのフックをいい感じにプログラミングする
前回の記事で紹介しました Zpoline というシステムコールフックの仕組みだと、バイナリ書き換え後の関数を、システムコールフックから呼び出してしまうと、デッドロックもしくは無限ループが発生することがあるという問題がありました。
結果として、システムコールフックの実装に標準ライブラリ内の機能、例えば、printf 等が使えなくてプログラミングがしにくくなっていました。
この問題は、dlmopen という機能を使うと解決できると教えて頂いて、実際に大分簡単にフック関数を実装できるようになったので、今回の記事では、具体的な Zpoline での利用方法について説明します。
以下の GitHub 上のリポジトリに置いてあるソースコードは dlmopen を利用できるように変更してありますので、よかったら是非試してみてください。
dlmopen の前に dlopen とは?
dlmopen は dlopen という機能の拡張です。dlmopen の前に、簡単に dlopen について説明します。
dlopen を利用すると、プログラムの中から、任意の共有ライブラリファイルをロードすることができます。
具体例として、以下のようなサンプルプログラムを用意してみました。
dlopentest.c
#include <dlfcn.h>

int main(void)
{
	void (*example_fn)(void);
	void *handle = dlopen("./libdlopentest.so", RTLD_NOW);
	example_fn = dlsym(handle, "example_function");
	example_fn();
	dlclose(handle);
	return 0;
}
libdlopentest.c
#include <stdio.h>

void example_function(void)
{
	printf("I'm example_function\n");
}
上のプログラムはそれぞれ以下のコマンドでコンパイルできます。
$ gcc dlopentest.c -ldl
$ gcc -shared -fPIC -o libdlopentest.so libdlopentest.c
生成された a.out を実行すると以下のような出力になります。
$ ./a.out
I'm example_function
上のサンプルでは、a.out (dlopentest.c) の中から、libdlopentest.so (libdlopentest.c) という共有ライブラリファイルを dlopen を使ってロードし、その中に実装されている、example_function という名前の関数を実行しています。
多くの場合、共有ライブラリをプログラムに組み込むには、例えば今回の例では、以下のように -l[ライブラリ名] のようにコンパイラに対して指定すると思いますが、
$ gcc dlopentest.c -ldlopentest # これは例で実際には動きません
dlopen を利用すると、コンパイラによる紐付けとは別にプログラムの中から共有ライブラリをロードすることができます。
dlmopen
dlmopen は dlopen と、基本的に共有ライブラリをプログラム内へロードできるという点で同じですが、共有ライブラリをロードする名前空間を指定できるという拡張を実装している点で異なります。
ライブラリのロードされる名前空間を分けることで、ある特定の実装が、デフォルトでロードされているライブラリ実装、例えば libc を利用しないようにできます。
具体的にどういうことか、わかりにくいと思いましたので、以下にサンプルプログラムを用意してみました。以下のプログラムでは、dlopen もしくは dlmopen を使って、共有ライブラリをデフォルトとは別の名前空間にロードした後で、main() と example_function() が利用している printf のアドレスを出力しています。dlopen と dlmopen のどちらを利用するかは、プログラム (a.out ) の引数で指定できます。(0 => dlopen, 0 以外 => dlmopoen)
dlmopentest.c
#ifndef _GNU_SOURCE
#define _GNU_SOURCE
#endif
#include <stdio.h>
#include <stdlib.h>
#include <dlfcn.h>

int main(int argc, char const* argv[])
{
	void (*example_fn)(void);
	void *handle;
	if (atoi(argv[1]) == 0) {
		printf("use dlopen: printf used by main and example_function will be the same\n");
		handle = dlopen("./libdlmopentest.so", RTLD_NOW | RTLD_LOCAL);
	} else {
		printf("use dlmopen: printf used by main and example_function will be different\n");
		handle = dlmopen(LM_ID_NEWLM, "./libdlmopentest.so", RTLD_NOW | RTLD_LOCAL);
	}
	example_fn = dlsym(handle, "example_function");
	printf("I'm main (printf is at %p)\n", printf);
	example_fn();
	dlclose(handle);
	return 0;
}
libdlmopentest.c
#include <stdio.h>

void example_function(void)
{
	printf("I'm example_function (printf is at %p)\n", printf);
}
上のプログラムは以下のコマンドでコンパイルできます。
$ gcc dlmopentest.c -ldl
$ gcc -shared -fPIC -o libdlmopentest.so libdlmopentest.c
以下はプログラムの出力の例です。
$ ./a.out 0
use dlopen: printf used by main and example_function will be the same
I'm main (printf is at 0x7f26b8dfce10)
I'm example_function (printf is at 0x7f26b8dfce10)

$ ./a.out 1
use dlmopen: printf used by main and example_function will be different
I'm main (printf is at 0x7fb852ce0e10)
I'm example_function (printf is at 0x7fb852ad2e10)
dlopen を利用した場合(上の出力では $ ./a.out 0 の場合)は、main と example_function が表示する printf のアドレスが同じ(0x7f26b8dfce10)である一方、dlmopen を利用すると(上の出力で $ ./a.out 1 の場合)、それぞれが異なるアドレス(main: 0x7fb852ce0e10 と example_function: 0x7fb852ad2e10)を表示しています。
これは、dlmopen が libdlmopentest.so と libdlmopentest.so が依存しているライブラリ(今回は libc)を、デフォルトとは異なる新しい名前空間にロードし、libdlmopentest.so 内部の実装が、新しい名前空間にロードされた libc を利用するように設定してくれたからです。
今回は、libdlmopentest.so に実装されている example_function がデフォルトの libc を利用しなくなった、というところがポイントです。
Zpoline で dlmopen を利用する
これまでの Zpoline を利用した場合のフック関数実装についての問題は、フック関数が、フック適用対象のプログラムのために用意されたライブラリ等のリソースを利用してしまうことに起因しました。
dlmopen を利用すると、フック関数のためだけにライブラリのようなリソースを新しく用意することができ、また、フック関数から、フック適用対象のプログラムのためのリソースを利用しないようにできる、というのが今回のポイントです。
今回の実装では、Zpoline の初期化用の共有ライブラリと、フック関数実装を、別々の共有ライブラリとしてコンパイルします。
初期化用の共有ライブラリは、LD_PRELOAD でロードされることを想定しており、フック適用対象のプログラムの main() が開始する前に、トランポリンコードの用意とバイナリ書き換えを行います。さらに、その後、dlmopen を使って、フック関数の実装を含む共有ライブラリを、新しい名前空間へロードします。
実装
以下のコードが、Zpoline で dlmopen を利用する初期化用ライブラリ(LD_PRELOAD でロードされる方)の実装です。以下では、フック関数は、LIBZPHOOK という環境変数に指定された共有ライブラリの中で、__hook_fn という名前で実装していることを想定しています。(わかりやすさのために簡略化してあります。詳しくはソースコードをご参照ください。)
static long (*hook_fn)(int64_t a1, int64_t a2, int64_t a3,
		       int64_t a4, int64_t a5, int64_t a6,
		       int64_t a7) = NULL;

/* trampoline code will jump to syscall_hook */
long syscall_hook(int64_t a1, int64_t a2, int64_t a3,
		  int64_t a4, int64_t a5, int64_t a6,
		  int64_t a7)
{
	return hook_fn(a1, a2, a3, a4, a5, a6, a7);
}

static void load_hook_lib(void)
{
	void *handle;
	const char *filename;

	filename = getenv("LIBZPHOOK");

	handle = dlmopen(LM_ID_NEWLM, filename, RTLD_NOW | RTLD_LOCAL);

	hook_fn = dlsym(handle, "__hook_fn");
}

__attribute__((constructor(0xffff))) static void __zpoline_init(void)
{
	setup_trampoline();

	rewrite_code();

	load_hook_lib(); // load hook function library
}
上のコードでは、LD_PRELOAD によってロードされた時に、__zpoline_init が最初に実行されることを想定しています。
__zpoline_init
__zpoline_init は、トランポリンコードを用意して (setup_trampoline)、バイナリ書き換えを行った後 (rewrite_code)、フック実装を含んだ共有ライブラリを dlmopen を使ってロードします (load_hook_lib)。
load_hook_lib
上のコード内の load_hook_lib では、dlmopen を使って、LIBZPHOOK という環境変数に指定された、フック関数の実装を含む共有ライブラリを、新しい名前空間にロードします。
この新しい名前空間にロードされたプログラムに対しては、バイナリ書き換えは行いません。結果として、フック関数内で、通常であればシステムコールを発行するライブラリ関数等を呼び出したとしても、そのシステムコールはフックされず、そのままカーネルに対してシステムコールが発行されます。
フック関数実装を含む共有ライブラリのロード完了後に、dlsym という機能を使って、フック関数である __hook_fn という名前の関数を探し、そのアドレスを hook_fn という名前のポインタへ代入します。
syscall_hook
バイナリ書き換え後は、フック適用後のプログラムが発行しようとしたシステムコールはフックされ、syscall_hook という関数へリダイレクトされるようになります。この中で、先ほどの hook_fn (つまり共有ライブラリ内の __hook_fn)を呼び出します。
独自のフック関数を実装するには
独自のシステムコールフックを実装するには、今回の例では、__hook_fn という名前のフック関数を実装し、独立した共有ライブラリとしてコンパイルすると良いと思われます。
上の例をそのまま使うと、仮に、__hook_fn を含む共有ライブラリを ./apps/basic/libzphook_basic.so というパスにコンパイルして設置した場合には、以下のようなコマンドで、独自の __hook_fn 実装をフック関数として適用できます。
$ LIBZPHOOK=./apps/basic/libzphook_basic.so LD_PRELOAD=./libzpoline.so [program you wish to run]
以下は、フック関数実装の例です。以下の __hook_fn は a1 にシステムコール番号、a2~a7 へシステムコールの引数が入ってきます。この中で、例えば、実際にシステムコールを発行することも、システムコールをエミュレートすることもできます。(簡略化してありますので、詳細は GitHub 上のサンプルプログラムを見てみてください。)
#include <stdio.h>
#include <stdint.h>
#include <unistd.h>
#include <syscall.h>

long __hook_fn(int64_t a1, int64_t a2, int64_t a3,
	       int64_t a4, int64_t a5, int64_t a6,
	       int64_t a7)
{
	printf("output from __hook_fn: syscall number %ld\n", a1);
	return syscall(a1, a2, a3, a4, a5, a6, a7);
}
まとめ
dlmopen を利用して、Zpoline でのフック関数実装を簡単にする方法について説明しました。詳細については、Github 上のリポジトリにあるサンプルプログラムをご参照ください。比較的簡単に色々な仕組みへ組み込めるようになったと思いますので、よろしければ、是非使ってみてください。
ptrace より 100 倍速いシステムコールフック作った
新しい高性能で汎用的なシステムコールフックの仕組みを作ってみました。
モチベーションとして、システムコールをフックしてユーザー空間でエミュレートしたくなったのですが、現状、性能と汎用性を両立する仕組みがなさそうだったので、新しい方法を考えました。
今回のシステムコールフックの仕組みは以下のような特徴があります。
- ptrace より 100 倍以上高速
- LD_PRELOAD や既存のバイナリ書き換えツールより確実
- カーネルへの変更なし、かつカーネルモジュールを使わない
- プログラムのソースコード、プログラムの再コンパイル不要
eBPF でトレーシングをしているけれど、できれば制約が少ないユーザー空間でトレーシングツールを作りたい。もしくは、gVisor のようなサンドボックスを作りたいけれど、ptrace による性能劣化が大きいので、他の高速なシステムコールフックの仕組みが使いたい、というような場合に利用できると思います。
今回は、Linux と x86-64 アーキテクチャを想定して実装してみました。
ソースコードは GitHub へ置いてあるので、よかったら試してみてください。
以下に、新しい仕組みの詳細を書いていきます。
上記の方法の問題点
ですが、上記の5つの方法は、性能もしくは汎用性についての問題が見受けられました。
- 既存のカーネル機能:ptrace、SUD はオーバーヘッドが大きい(性能)
- カーネルの変更、カーネルモジュール:通常の環境で使えない(汎用性)
- プログラムの再コンパイル:ソースコードが必ずしも手に入らない(汎用性)
- LD_PRELOAD:ライブラリ関数でラップされていないシステムコールはフックできない(汎用性)
- バイナリ書き換えツール:100% の書き換え成功を保証できない(汎用性)
このことから、現状では、性能と汎用性を両立できる、ユーザー空間でシステムコールフックを実装可能な仕組みはなさそうでした。
今回考えたシステムコールフックの仕組み:Zpoline
今回考えた、Zpoline という仕組みは、プログラムのバイナリが実行前にメモリに読み込まれた段階で、バイナリ書き換えを行います。ですので、Zpoline は、バイナリ書き換えにカテゴライズされますが、プログラムのバイナリ"ファイル"自体は上書きしません。
前提知識:x86-64 でのシステムコール
システムコールは、ユーザー空間のプログラムが、カーネル機能へアクセスするためのインターフェースとして利用されます。
実装として、ユーザー空間プログラムは syscall もしくは sysenter という CPU 命令を利用することで、システムコールを発行できます。
ユーザー空間プログラムが syscall/sysenter 命令を実行すると、実行コンテキストがカーネル空間へ切り替わり、カーネルが予め設定したシステムコール ハンドラへ処理が以降します。
解決する問題:バイナリ書き換え固有の問題
Zpoline はバイナリ書き換えによって、システムコールのフックを実装しますが、バイナリ書き換えの仕組みには、100% の書き換え成功を担保することが難しいという問題があります。
具体的な難しさは、ある CPU 命令を、それよりも大きな CPU 命令と置き換える、という点にあります。
まず、syscall と sysenter CPU 命令は、それぞれ、0x0f 0x05 と 0x0f 0x34 という 2 byte のオペコードで表されます。
今回は、それらを任意のユーザー空間にあるシステムコールフック関数へ処理を飛ばすための、jmp もしくは call 命令と置き換えることを目指します。
問題点は、jmp と call 命令は、2 byte だけでは、任意のフック関数へのジャンプを実装することが難しいということにあります。なぜかというと、それらの命令は、ジャンプの宛先のアドレス(今回ならフック関数のアドレス)を指定する必要があり、それには 2 byte 以上が必要になるからです。
プログラムのバイナリの中では、syscall / sysenter 命令以降には、次の命令が書いてあるので、jmp / call 命令がはみ出ると、それらを上書きして、プログラムを壊してしまうことになります。結果として、既存のバイナリ書き換えツールでは、100% の書き換え成功を担保することが難しくなっています。
Zpoline のアイデア
Zpoline のアイデアは、システムコールの呼出規約をうまく使って、それに合わせてバイナリ書き換えを行い、かつ適切にトランポリンコードを用意することです。
以下の図に、外観を示します。
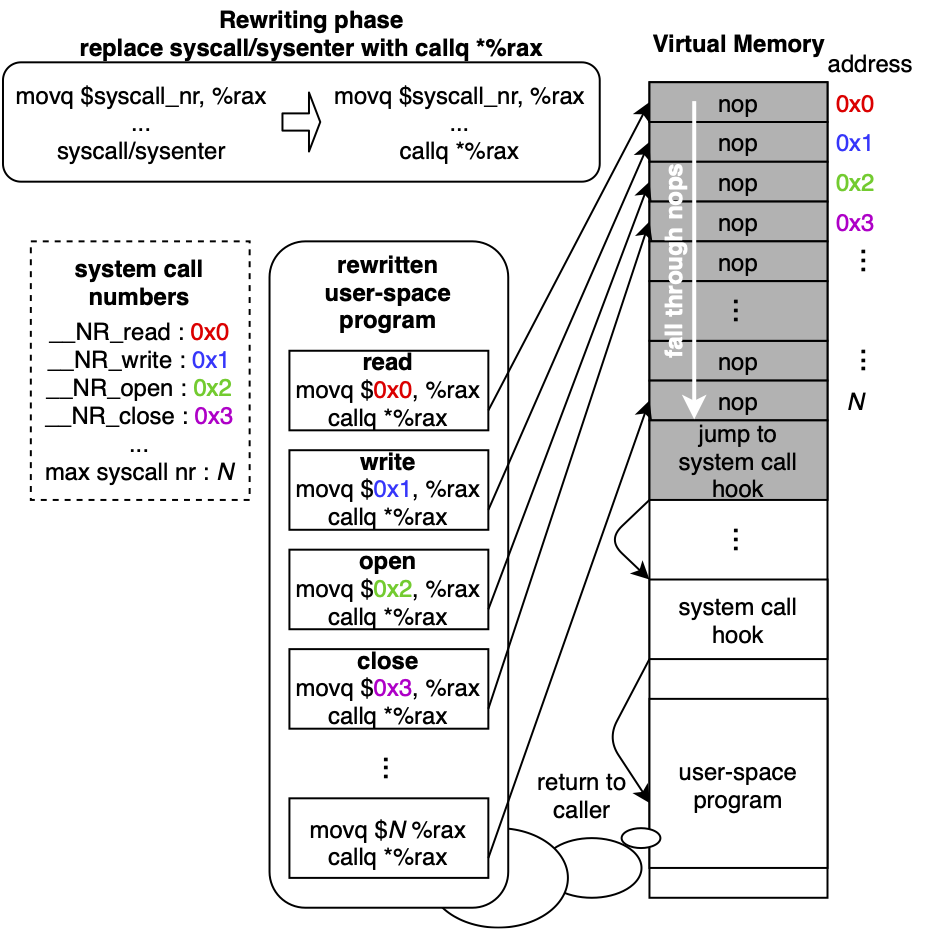
バイナリ書き換え
具体的には、syscall / sysenter 命令を callq *%rax という 0xff 0xd0 で表される 2 byte の命令で書き換えます。ここで、大事なポイントは、callq *%rax は syscall / sysenter 命令と同じ 2 byte なので、他の箇所に影響を与えずに、単純に置き換えることができます。
さて、callq *%rax が何をするのかというと、%rax CPU レジスタへ入った値を宛先アドレスとして、ジャンプします。また、callq は call 系列の命令なので、ジャンプ元のアドレスはスタックへ push します。
ここで、システムコールの呼出規約を使います。前述の通り、Linux の呼出規約では、%rax へは、システムコール番号が入っています。システムコール番号は、カーネルの定義によって、0 から始まり 400~500 程度までに収まる数なので、callq *%rax が飛ぶ宛先アドレスは必ず 0 ~ 500 程度になります。
Zpoline では、そのアドレス 0 ~ 500 の含まれる領域にトランポリンコードを用意し、任意のシステムコールフック関数へのジャンプを実装します。Zpoline の名前は、tramPOLINE code をアドレス 0 ( Zero ) に設定することから来ています。
トランポリンコード
トランポリンコードの用意は、mmap システムコール を使って、メモリをアドレス 0 に確保することから始まります。Linux では、デフォルトでは、アドレス 0 は mmap できないようになっていますが、/proc/sys/vm/mmap_min_addr に 0 を設定すると、通常ユーザーでもアドレス 0 にメモリをマップできるようになります。
次に、アドレス 0 から最大のシステムコール番号までを nop 命令 ( 0x90 ) で埋めます。その後、最後の nop 命令の次に、任意のシステムコールフック関数へジャンプするためのコードを埋め込みます。
その結果、syscall / sysenter を置き換えた callq *%rax は、トランポリンコードの上の nop 命令のどれかへのジャンプになります。nop 命令に飛んだ後は、システムコール フックへのジャンプのコードへ行き着くまで、続く nop 命令を実行します。
これにより、任意のフック関数へのジャンプが実装できました。
また、callq *%rax の呼び出し元のアドレスは、callq 命令のおかげでスタックに保存されているので、フック関数の return は callq *%rax の呼び出し元への return になります。
実装
Zpoline で LD_PRELOAD でロードされることを想定したライブラリとして実装されており、プログラムの main 関数が実行され始める前に、トランポリンコードとバイナリ書き換えを行います。これにより、Zpoline はどんなプログラムに対してもシステムコールフックを適用できます。LD_PREALOD を使っていますが、既存の仕組みのように、ライブラリ関数の書き換えは行いません。
独自のシステムコールフックは、LD_PRELOAD でロードされるライブラリの中に実装することができます。
1点、既存のバイナリ書き換えの仕組みや、Syscall User Dispatch と同様に、フックを適用する対象のプログラムが呼び出す可能性のある関数を、フックから呼び出す場合には注意が必要です。例えば、function_A という関数があり、内部の実装が、ロックを確保し、あるシステムコールを実行、その後、ロックを開放する、とします。仮に、フック適用対象のプログラムが function_A を呼び出すと、その中のシステムコールは、Zpoline によってフックされます。問題は、フックが function_A を呼び出すと、デッドロックが発生します。なぜなら、最初に呼び出された function_A の中で、ロックがリリースされていないからです。
このような問題については、フック関数が利用するリソースを、フック適用対象のプログラムと分けることで、回避できます。今後、フック関数の実装に役に立ちそうな実装を追加する予定でいます。
性能
簡単に、Zpoline を利用して作ったシステムコールフックの仕組みを ptrace と Syscall User Dispatch と比較してみました。
とても単純な、プロセスの pid を取得する getpid をトラップして、代わりにシステムコールを実行するために必要な CPU サイクルを計測しました。さらに、pid をキャッシュして、実際には getpid システムコールを実行しないで、キャッシュした値を返すエミュレーションも実装して、同様に CPU サイクルを計測しました。計測には、Intel Xeon E5-2640 v3 CPU 2.60 GHz と Linux-5.11 ( Ubuntu 20.04 ) を利用しました。
以下が計測結果です。
| Hook Mechanism | without pid cache | with pid cache |
|---|---|---|
| ptrace | 17820 | 16403 |
| Syscall User Dispatch | 5957 | 4563 |
| Zpoline | 1459 | 138 |
Zpoline は ptrace と Syscall User Dispatch よりも遥かに少ない CPU サイクルでシステムコールをフックできることがわかりました。
特に、システムコールフック自体のオーバーヘッドは、getpid システムコールのオーバーヘッドが含まれない with pid cache のケースに見ることができます。今回の環境では、Zpoline は ptrace より 118 倍高速であるという結果になりました。
Linux カーネルハック実践入門
Linux のカーネルハックの実践的な入門方法について書いてみようと思います。
カーネルハックをすると、OS の機能を改変したり、追加したりできます。
OS の機能の例としては、スケジューラ、メモリ管理機能、ネットワークスタック、ファイルシステム、デバイスドライバ等があります。
今回の記事では、具体的にどうすればカーネルの機能を改変したり、追加したりできるのかについて書いていきます。
特に今回は、カーネルモジュールを使ったカーネルハックの方法について書いていきます。
カーネルハックに関する事前知識や、カーネルモジュールとして実装ことの利点については過去の記事にまとめてありますので、よろしければそちらもご参照ください。
具体的には、既存のファイルシステムをハックして機能を追加してみようと思います。
必要な準備
1. Linux がインストールされた仮想マシン
Linux のカーネルハックを行うには、Linux がインストールされたコンピューターが必要です。
Windows や Mac を利用している場合でも、仮想化ソフトウェアを利用すると、Windows や Mac の上で、Linux の仮想マシンを実行することができます。
Linux のデスクトップ機を利用されている場合でも、カーネルハックを行っている際に、追加した内容にバグがあるとシステムが破損する恐れがあるので、安全のために仮想マシンを利用されることをおすすめします。
この記事を書いている時点で、デスクトップ環境で利用可能な仮想化ソフトウェアには以下のようなものがあります。お使いの環境に合わせて選んでください。
- VirtualBox ( Windows、Mac、Linux で無償で利用可能 )
- VMware Workstation Player ( Windows と Linux 用 無償ライセンスあり)
- VMware Fusion ( Mac 用 有償 )
- Parallels Desktop ( Mac 用 有償 )
- virt-manager ( Linux 用 無償 )
Linux を仮想マシンにインストールする場合には、ディストリビューションごとに配布されているインストーラを利用する必要があります。
Linux カーネルは OS の基本的な部分であって、Graphical User Interface (GUI) などはカーネル自体には含まれておらず、一般的に人が使うためには多くの付属ソフトウェアが必要になります。
ディストリビューションは、Linux を汎用的に利用できるように付属ソフトウェアをまとめて簡単に利用可能なようにしてくれているものです。
ディストリビューションの種類はたくさんありますが、有名なものとして以下のようなものがあります。
今回の記事では、Ubuntu 20.04 を利用しています。ディストリビューションが異なると、パッケージのインストールのコマンドが大きく異なりますが、根本的な部分については同じです。
具体的な Linux を仮想マシンへインストールする方法については、仮想化ソフトウェアとディストリビューションに依存するのと、インターネット上にたくさん情報があるので割愛します。
例えば、”Ubuntu VirtualBox インストール” のようなフレーズで検索すると情報が出て来やすいと思います。
2. Linux のソースコード
カーネルハックでは、カーネルの機能を変更するので、カーネルのソースコードが必要になります。
Linux カーネルにはバージョンがあり、バージョンごとにソースコードの内容が異なります。
今回は、仮想マシンに既にインストールされている Linux と同じバージョンのソースコードを入手します。インストールされている Linux カーネルのバージョンと、ソースコードのバージョンが異なると、実験がうまくいかないことがあるので、注意してください。
Linux カーネルのソースコードは The Linux Kernel Archives というホームページで配布されていますが、今回はホームページからではなく、特定のバージョンのソースコードを取得するために、CDN の URL からダウンロードします。
仮想マシンにインストールされている Linux のバージョンは以下のコマンドを仮想マシン内で実行すると得られます。
$ uname -r
5.4.0-40-generic
上記のコマンド出力の結果、カーネルのバージョンが 5.4.0 であることがわかりました。
仮想マシンで、以下のコマンドを実行すると、Linux のバージョン 5.4 のソースコードが取得できます。実験の際には、手元の仮想マシンにインストールされている Linux カーネルと同じバージョンを取得できるように、コマンド内のバージョン番号を変更してください。
インストールされている Linux カーネルのバージョンが 3.~ や、4.~ の場合は、URL の最後から一つ前の項目を v5.x から、v3.x や v4.x に適宜変更してください。
$ wget https://cdn.kernel.org/pub/linux/kernel/v5.x/linux-5.4.tar.gz
また、ブラウザで以下の URL に直接アクセスしてダウンロードすることもできます。ホスト側のブラウザを使うと、ホストにファイルがダウンロードされるので、ダウンロード完了後には、仮想マシンへファイルをコピーする必要があります。
ダウンロードできたら、仮想マシン内で以下のコマンドを実行して、ソースコードを展開します。
$ tar xvf linux-5.4.tar.gz
最初のカーネルモジュール
動作確認も兼ねて、最小構成のカーネルモジュールをコンパイルしてインストールしてみましょう。
ソースコードは GitHub に置いてありますので、よかったら試してみてください。
今回のカーネルモジュールの C プログラムは以下のようになります。kmod.c という名前をつけて保存します。
#include <linux/kernel.h>
#include <linux/module.h>

static int __init kmod_init(void)
{
        printk(KERN_INFO "kernel module is loaded\n");
        return 0;
}

static void __exit kmod_exit(void)
{
        printk(KERN_INFO "kernel module is unloaded\n");
}

module_init(kmod_init);
module_exit(kmod_exit);

MODULE_LICENSE("GPL v2");
以下が、kmod.c をカーネルモジュールとしてビルドするための Makefile です。
PWD := $(shell pwd)
KDIR := /lib/modules/$(shell uname -r)/build

obj-m += kmod.o

EXTRA_CFLAGS=-I$(PWD)/include

SUBDIRS := $(PWD)
COMMON_OPS = -C $(KDIR) M='$(SUBDIRS)' EXTRA_CFLAGS='$(EXTRA_CFLAGS)'

deafult:
        $(MAKE) $(COMMON_OPS) modules

clean:
        rm -rf *.o *.ko *.cmd *.mod.c *.mod .*.cmd .tmp_versions modules.order Module.symvers *~
上の kmod.c と Makefile を置いてあるディレクトリの中で以下のように make コマンドを実行すると kmod.ko というカーネルモジュールのファイルがビルドされます。
$ make
動作確認のために、インストールしてみます。カーネルモジュールのインストールには、以下のように insmod コマンドを利用します。
$ sudo insmod kmod.ko
insmod を実行した後に、dmesg コマンドを実行してみてください。一番下の方に以下のようなメッセージが表示されていれば成功です。
$ dmesg
...
[  305.841891] kernel module is loaded
カーネルモジュールをアンインストールするには、rmmod コマンドを実行します。
$ sudo rmmod kmod
rmmod コマンドを実行した後に、再度 dmesg を実行してみてください。以下のようにメッセージが追加されているはずです。
$ dmesg
...
[  305.841891] kernel module is loaded
[  326.462975] kernel module is unloaded
kmod.c についての簡単な説明
kmod.c はカーネル空間で動作するプログラムです。プログラムの書き方自体は、Linux カーネルそのものと同じです。
Linux カーネルのプログラミングは、基本的に C 言語ですが、ユーザー空間で動作するプログラムと異なる点が多くあります。ポイントは、標準ライブラリは利用できず、Linux カーネル内部で用意されている関数を利用する必要があることです。
まず、printf が使えません。代わりに、ログを出力する printk という関数が用意されており、デバッグの際には概ね代用できます。
module_init と module_exit は、Linux カーネルが内部的に用意している関数で、それぞれ、カーネルモジュールをインストールしたときと、アンインストールしたときに実行される関数を登録できます。
カーネルモジュールを使ったカーネルハックを始める
最小構成のカーネルモジュールをどうやって作るのかはわかりました。次に、カーネルモジュールの仕組みを使うと何ができるのかについて見ていきます。
ここからが実践的な内容になります。
今回は、Linux カーネルのソースコード内にある MINIX ファイルシステムを、独立したカーネルモジュールとしてビルドしてハックしてみます。
これを応用すると、他の種類のファイルシステムや、デバイスドライバなどの挙動を簡単に変えることができるようになります。
改変後のソースコードを GitHub へ置いておきますので、よろしければご参照ください。コミットのログを見ると、どこが、どのように変更されたかわかりやすいと思います。手元に clone した場合は、git log -p とすると、詳細な変更の履歴が見られます。
1. MINIX ファイルシステムをカーネルモジュールとしてビルドする
まずは、作業用に MINIX ファイルシステムのソースコードをすべてコピーしましょう。これはどこのディレクトリにコピーしてもかまいません。
$ cp -r linux-5.4/fs/minix ./
次に、コピーした MINIX ファイルシステムのディレクトリの中に入って、make コマンドを実行してみます。
$ cd minix
$ make: *** No targets.  Stop.
そのままでは、上記のように、No targets と言われて何も起こりません。
MINIX ファイルシステムの Makefile の中身は以下のようになっています。
# SPDX-License-Identifier: GPL-2.0-only
#
# Makefile for the Linux minix filesystem routines.
#

obj-$(CONFIG_MINIX_FS) += minix.o

minix-objs := bitmap.o itree_v1.o itree_v2.o namei.o inode.o file.o dir.o
ここで、最初に作った最小のカーネルモジュール用の Makefile と比べてみると、MINIX ファイルシステムの Makefile には不足している部分が多くあるのがわかります。
その不足部分が MINIX ファイルシステムをカーネルモジュールとして直接コンパイルできない理由なので、足りない部分を手で追加しましょう。
ポイントは、obj-$(CONFIG_...) の個所を obj-m に変更することと、default: 以下に make コマンド実行時に何をすべきかを書くことです。
以下が変更後の Makefile です。
# SPDX-License-Identifier: GPL-2.0-only
#
# Makefile for the Linux minix filesystem routines.
#

PWD := $(shell pwd)
KDIR := /lib/modules/$(shell uname -r)/build

obj-m += minix.o

minix-objs := bitmap.o itree_v1.o itree_v2.o namei.o inode.o file.o dir.o

EXTRA_CFLAGS=-I$(PWD)/include

SUBDIRS := $(PWD)
COMMON_OPS = -C $(KDIR) M='$(SUBDIRS)' EXTRA_CFLAGS='$(EXTRA_CFLAGS)'

deafult:
        $(MAKE) $(COMMON_OPS) modules

clean:
        rm -rf *.o *.ko *.cmd *.mod.c *.mod .*.cmd .tmp_versions modules.order Module.symvers *~
Makefile を上のように書き換えた後に、再度 make コマンドを実行してみると、今度はコンパイルが成功して、minix.ko というファイルが生成されるはずです。
実際に使えるか試してみましょう。以下のコマンドで、コンパイルされたカーネルモジュールをインストールできます。
$ sudo insmod minix.ko
次に、実験のため、MINIX ファイルシステム用にディスクを用意しましょう。今回は、RAM ディスクを使って実験してみましょう。RAM ディスクは、brd というカーネルモジュールを使うと作ることができます。以下のコマンドで、brd のカーネルモジュールをロードしてください。
$ sudo modprobe brd
上記のコマンドを実行すると、/dev/ram0 というパスに、RAM ディスクができます。今度は、以下のコマンドを実行して、/dev/ram0 を MINIX ファイルシステム用に初期化(フォーマット)しましょう。
mkfs コマンドで他のディスクを初期化しないように注意してください。間違って操作すると、重要なデータが消えてしまう可能性があります。
$ sudo mkfs.minix /dev/ram0
以上で、ディスクの準備が完了したので、MINIX ファイルシステムをマウントしていきましょう。今回は、~/testmnt というディレクトリに MINIX ファイルシステム用に初期化した /dev/ram0 をマウントします。
$ mkdir ~/testmnt
$ sudo mount /dev/ram0 ~/testmnt
これで、マウントが完了し、~/testmnt 以下のファイルは、さきほどビルドした MINIX ファイルシステムのカーネルモジュールによって管理されるようになりました。
最後に、簡単のため ~/testmnt ディレクトリ以下のファイルの所有権をユーザーのものに変えておきましょう。
$ sudo chown -R $USER:$USER ~/testmnt
マウントを解除する場合には、以下のコマンドを実行します。
$ sudo umount ~/testmnt
MINIX ファイルシステムのカーネルモジュールをアンインストールするためには、以下のコマンドを実行します。以下のコマンドは、マウントを解除した後で実行する必要があります。
$ sudo rmmod minix
ここまでで、MINIX ファイルシステムが、独立したカーネルモジュールとして利用できるようになりました。
ポイントは、Makefile しか既存のソースコードに変更を加えていない点です。Makefile を少し変更するだけで、特定の機能を切り出して改変することができるようになります。
2. MINIX ファイルシステムをハックする
これまでのステップで、MINIX ファイルシステムがカーネルモジュールとしてビルドして利用できるようになりました。
やっとここからカーネルハックを始めていきます。
今回は、ファイルシステム全体で、write システムコールを使って書き込まれたバイト数を保持するとともに、ユーザー空間側から確認できるようにしてみます。
そのような機能は、file.c を以下のように変更すると実装できます。(簡単のため並列での書き込みは想定しておりません。)
diff --git a/file.c b/file.c
index c50b0a2..1c3525d 100644
--- a/file.c
+++ b/file.c
@@ -9,6 +9,20 @@

 #include "minix.h"

+#include <linux/uio.h>
+#include <linux/moduleparam.h>
+
+static long syscall_write_bytes;
+module_param(syscall_write_bytes, long, 0444);
+
+static ssize_t minix_file_write_iter(struct kiocb *iocb, struct iov_iter *from)
+{
+       syscall_write_bytes += from->count;
+       printk(KERN_INFO "write %ld bytes, current total %ld bytes\n",
+                       from->count, syscall_write_bytes);
+       return generic_file_write_iter(iocb, from);
+}
+
 /*
  * We have mostly NULLs here: the current defaults are OK for
  * the minix filesystem.
@@ -16,7 +30,7 @@
 const struct file_operations minix_file_operations = {
        .llseek         = generic_file_llseek,
        .read_iter      = generic_file_read_iter,
-       .write_iter     = generic_file_write_iter,
+       .write_iter     = minix_file_write_iter,
        .mmap           = generic_file_mmap,
        .fsync          = generic_file_fsync,
        .splice_read    = generic_file_splice_read,
まずは動作確認から
上記の変更を加えた後、コンパイルしなおして、再度カーネルモジュールをインストールしなおします。
以下のコマンドを、先ほど Makefile に変更を加えた MINIX ファイルシステムのソースコードの置いてあるディレクトリで実行すると、モジュールをリロードしたのち、ファイルシステムを ~/testmnt にマウントしなおします。
$ make clean
$ make
$ sudo umount ~/testmnt
$ sudo rmmod minix
$ sudo insmod minix.ko
$ sudo mount /dev/ram0 ~/testmnt
動作確認は、ユーザー空間で動作するプログラムを使って行います。
以下のプログラムをコピペして writer.c として保存してください。
このプログラムは、-l で指定された長さのデータを -f で指定されたファイルへ write システムコールを使って書き込みます。
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <fcntl.h>
#include <getopt.h>

int main(int argc, char* const* argv)
{
        int ch, fd;
        const char *filename = NULL;
        long length = 0, l;
        ssize_t written;
        char buf[1024] = { 0 };

        while ((ch = getopt(argc, argv, "f:l:")) != -1) {
                switch (ch) {
                case 'f':
                        filename = optarg;
                        break;
                case 'l':
                        length = atol(optarg);
                        break;
                default:
                        printf("unknown option\n");
                        exit(1);
                }
        }

        if (!filename) {
                printf("please specify a file name\n");
                exit(1);
        }
        if (length <= 0) {
                printf("please specify length\n");
                exit(1);
        }
        if (sizeof(buf) < length) {
                printf("please specify a smaller value than %ld\n", sizeof(buf));
                exit(1);
        }

        printf("write %ld bytes to %s\n", length, filename);

        fd = open(filename, O_CREAT | O_RDWR, 0644);
        if (fd < 0) {
                perror("open");
                exit(1);
        }

        written = write(fd, buf, length);
        if (written < 0) {
                perror("write");
                exit(1);
        }

        close(fd);

        return 0;
}
次のコマンドで、上記のプログラム(writer.c)をコンパイルして、writer というバイナリを生成します。
$ gcc writer.c -o writer
やっと動作確認です。
以下のようなコマンドを実行してみてください。以下のコマンドを3つ実行すると、896 ( 128 + 256 + 512 ) バイト分 write システムコールを呼びだします。
$ ./writer -f ~/testmnt/file1.txt -l 128
$ ./writer -f ~/testmnt/file1.txt -l 256
$ ./writer -f ~/testmnt/file2.txt -l 512
このコマンドを実行した後に、dmesg を実行してみてください。以下のようなメッセージが表示されていれば、カーネル空間でバイト数がカウントされていることが確認できます。上の3つのコマンドで 896 バイト分 write システムコールを呼んでいるので、total 896 bytes と表示されているのは意図した挙動です。
他にも vim 等のエディタで書き込みをしてみると、エディタは実は手でタイプしたよりたくさん書き込んでいる様子がわかったりするかもしれません。
$ dmesg
...
[ 7531.295107] write 128 bytes, current total 128 bytes
[ 7534.903116] write 256 bytes, current total 384 bytes
[ 7683.015261] write 512 bytes, current total 896 bytes
次に、以下のコマンドを実行してみてください。896 という数字が表示されていれば成功です。ここでは、sysfs というインターフェースを通して、ユーザー空間から、カーネル空間に保存されている値を取り出しています。
$ cat /sys/module/minix/parameters/syscall_write_bytes
896
プログラムの説明
file.c に加えた変更は主に以下の3点です。
1. カーネル空間にバイト数をカウントするための変数(syscall_write_bytes)を用意する
2. ユーザー空間から syscall_write_bytes の値を読み取れるように、module_param という仕組みを使って、sysfs に登録する
3. カーネル空間の write システムコールの入り口で、書き込みバイト数を取得して、syscall_write_bytes に加算する ( minix_file_write_iter )
sysfs について
sysfs はカーネル空間内部の情報をユーザー空間側からアクセスできるようにする手段の一つとして利用できます。
カーネルモジュールのソースコード内で、module_param という仕組みを使うと、/sys/module/モジュール名/parameters/変数名 のような特殊ファイルが生成され、変数の値にアクセスできるようになります。
file_operations 構造体について
file_operations 構造体は、カーネルの中で、ファイルに関するオブジェクトに紐づけられます。
上にあるように、メンバは、lseek や read、write システムコールのようなファイルに関連するシステムコールの実際の実装が登録されます。
この、file_operations 構造体に登録する関数によって、ファイル操作による挙動を変更できます。
例えば、Ubuntu 等でデフォルトで利用されている ext4 ファイルシステムは、ext4 ファイルシステムの独自の file_operations 構造体を実装することで、独自の挙動を実装します。別のファイルシステムである XFS は、XFS 独自の file_operations 構造体を持っています。
また、通信に用いられる socket も socket 特有の file_operations 構造体を実装しており、そのおかげでファイルデスクリプタを通して read や write ができます。
今回、変更したのは、MINIX ファイルシステムの file_operations 構造体です。
中でも、write_iter が write システムコールに対応しているので、今回は、対応するメンバの実装に変更を加えています。
他のカーネルモジュールを使う
例えば、Ubuntu では、ext4 がデフォルトのファイルシステムとして採用されていますが、ext4 をカーネルモジュールとしてビルドして実験しようとすると、既にインストールされていますと言われて insmod コマンドが失敗します。(今回、MINIX ファイルシステムを例としたのは、既存のシステムに利用されている可能性が低いと思ったからです。)
そのような場合には、ファイル名と、ファイルの中で利用されている変数名と関数名を変更すると競合を回避できます。
具体的には、ext4 であれば、ext4 と表記されているファイル名と変数名、関数名を全て、例えば、ext40 に変更すると競合することなく、独立したカーネルモジュールとしてコンパイル、インストールできます。
このように、カーネルモジュールとしてビルド、もしくはインストールできない場合は、少し手を加えると解決できることがたくさんあります。
また、どうしてもカーネルモジュールだけでは実装できない機能もありますので、その場合はカーネル自体をコンパイルしなおす必要があります。
